오늘 Mistral AI가 Mistral Large 4(ML4, 애칭 le Chonk)의 public preview를 공개했습니다. 헤드라인은 "1조 파라미터"지만, 이 모델을 이해하는 올바른 출발점은 다른 숫자입니다.
Total:  1.05T parameters
Active: 49B parameters per token
Vision: 1.6B encoder
Context: 1M tokens
즉 매 토큰마다 1조 개를 전부 계산하는 것이 아니라, 그중 필요한 expert 경로 약 49B만 활성화하는 granular MoE입니다. (공식 문서에는 임베딩·출력층을 포함한 표기로 52B active라는 숫자도 함께 나옵니다. 토큰당 라우팅되는 규모는 49B로 읽으면 됩니다.)
가중치는 아직 공개되지 않았고 10월 말 릴리스 예정입니다. 지금 쓸 수 있는 것은 Mistral Studio의 preview API입니다. "open-weight"라는 수식어는 약속이지 현재 상태가 아니라는 점을 먼저 깔고 가는 편이 정확합니다.
숫자부터 정리: 무엇이 새로울까?
공식 발표와 문서 기준으로 스펙을 모아보면 이렇습니다.
아키텍처   granular MoE, natively multimodal
총량       1.05T total parameters
활성량     49B active per token
비전       1.6B vision encoder
컨텍스트   1M tokens
입력       multimodal (텍스트 + 이미지·문서)
기능       function calling, Agents & Conversations,
           built-in tools, structured outputs
학습       유럽 데이터센터, Grace Blackwell 3,800대,
           처음부터(from scratch) 약 2개월
언어       160개 이상, EU 공식 언어 전부 포함
가격은 preview 기준 할인가가 표시돼 있습니다.
input         $0.68 / M tokens
cached input  $0.07 / M tokens
output        $2.09 / M tokens
원가 라인($1.36 / $0.14 / $4.18)에 취소선이 그어져 있으니, 정식 출시 후 가격이 바뀔 수 있다는 점은 염두에 두는 것이 좋습니다.
왜 "1조"보다 "49B"가 중요한가?
이 질문은 MoE active parameter 글에서 다룬 것과 정확히 같은 구조입니다.
1.05T → 모델의 전체 capacity, 저장해야 할 weight 규모
49B   → 토큰 하나를 처리할 때 실제 도는 계산 경로
1조라는 숫자가 말해주는 것은 "이 모델이 얼마나 많은 패턴을 나눠 저장할 수 있는가"이고, 49B가 말해주는 것은 "토큰 하나에 얼마의 계산비가 드는가"입니다. 추론 비용과 latency를 결정하는 쪽은 후자입니다.
Mistral이 이 방향을 택한 이유는 자명합니다. 코딩·에이전트 workload는 한 번의 호출로 끝나지 않고 수십~수백 턴의 tool calling과 추론을 반복합니다. 토큰당 계산량을 묶어두지 않으면 에이전트 workload의 단가가 감당되지 않습니다.
벤치마크는 "전문 workload"에 맞춰 읽자
Mistral이 내세운 성적을 보면 범용 챗봇 점수보다 특정 업무 장면에 방점이 찍혀 있습니다.
코딩         DeepSWE v1.1 61.7%, Terminal-Bench 4.0 28.3%,
             Coding Agent Index 49.8%
             (DeepSeek V4 Pro, Qwen3.8 Max 앞섬 — vendor 발표 기준)
인간 평가     Surge blind eval 코딩 품질 3.7 / 5, 2위
             (Claude Opus 5 4.2에 이어, Kimi K3·GLM-5.3 3.6 상회)
에이전트     AutomationBench 59.9% (Gmail·Sheets·Slack·Salesforce
             657개 업무 흐름), AA-Briefcase 1,393 Elo
사이버보안    AA Cyber Index 오픈웨이트 상위, Cybench 93%,
             취약점 재현→패치 과제 82% (해당 과제 최고)
법률·금융    Harvey Legal Agent·Finance Agent v2에서
             GPT-6-Astra 상회 (vals.ai 제3자 평가)
비전         Dense200 grounding 42% (GPT-6-Astra 41% 상회)
사이버보안 대목에는 실무적인 함의가 있습니다. 취약점이 실제로 존재함을 입증하는 재현 작업은 방어의 출발점인데, 강한 거부 필터를 가진 closed 모델은 이 지점에서 막히는 경우가 있습니다. Mistral은 이 문제를 "역량은 주되 배포 위치와 정책은 고객이 통제한다"는 open-weight 논리로 풀겠다고 합니다. 유럽 내 독립 운영 배포와 on-premise 실행 이야기가 나오는 이유입니다.
점수를 차트로 보면 구도가 한눈에 들어옵니다. DeepSWE 1.1에서는 ML4 Preview(주황, 62)가 Beam 자체 보고치(44)·Qwen3.8 Max(51)·DeepSeek V4 Pro(57)·GLM-5.3(61)을 앞지르고, Kimi K3(68)가 선두에 있습니다.
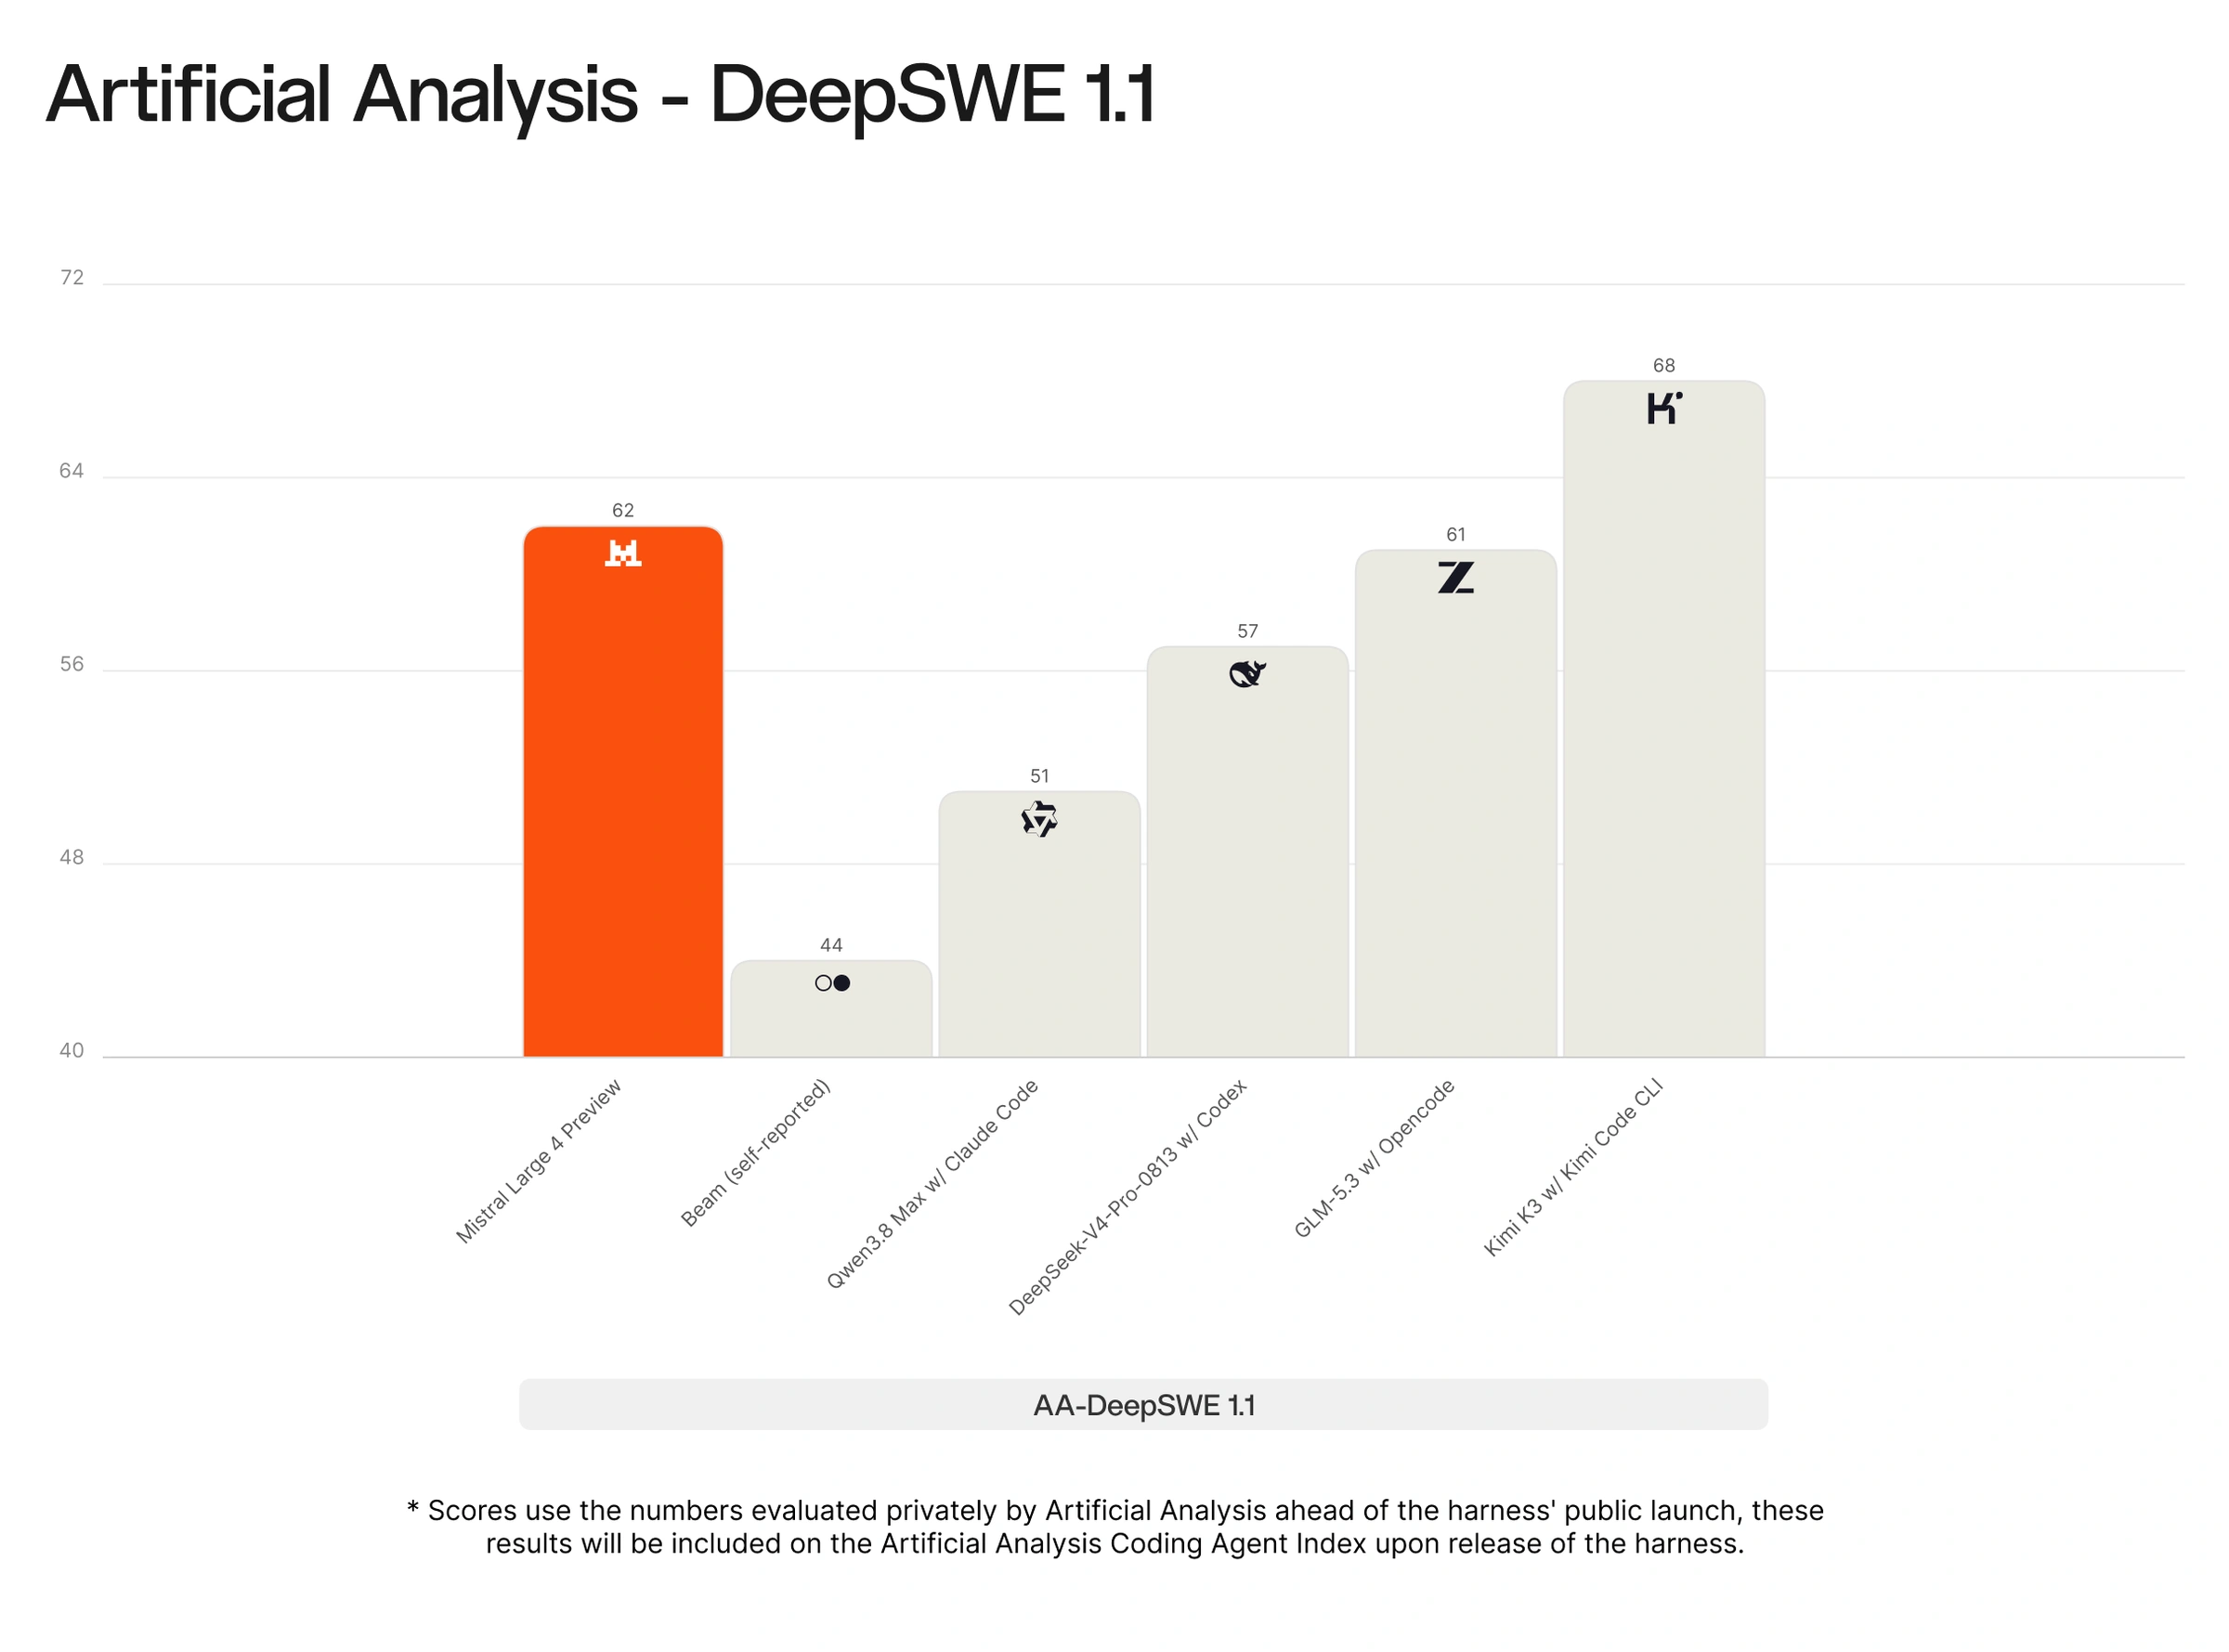
출처: Mistral AI 공식 발표 「Introducing Mistral Large 4」(2026-10-06). Artificial Analysis 측정이며 하네스별 조건이 다릅니다. Beam 수치는 Reflection 자체 보고치 표기로 게시됐습니다.
사이버보안 차트도 같은 구도입니다. AA Cyber Index에서 ML4 Preview와 GLM-5.3-Flash가 50으로 공동 선두이고, Kimi K3·DeepSeek V4.1-Flash가 41, GLM-5.3이 36입니다.
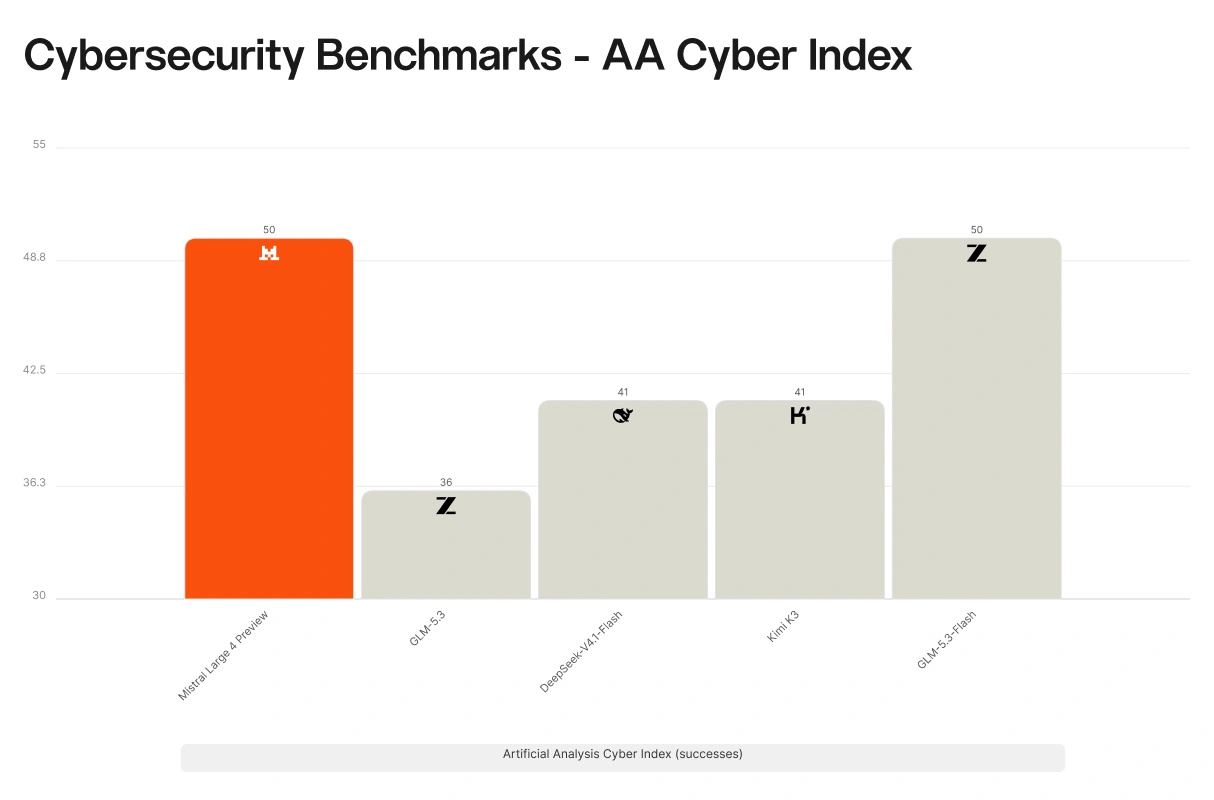
출처: Mistral AI 공식 발표 「Introducing Mistral Large 4」(2026-10-06). Artificial Analysis Cyber Index.
사람이 직접 매긴 점수도 방향이 같습니다. Surge blind eval(1–5점)에서 ML4 Preview가 3.7로 Claude Opus 5(4.2) 다음 2위, Kimi K3·GLM-5.3(3.6)과 GLM-5.2(3.4)를 앞섰습니다.
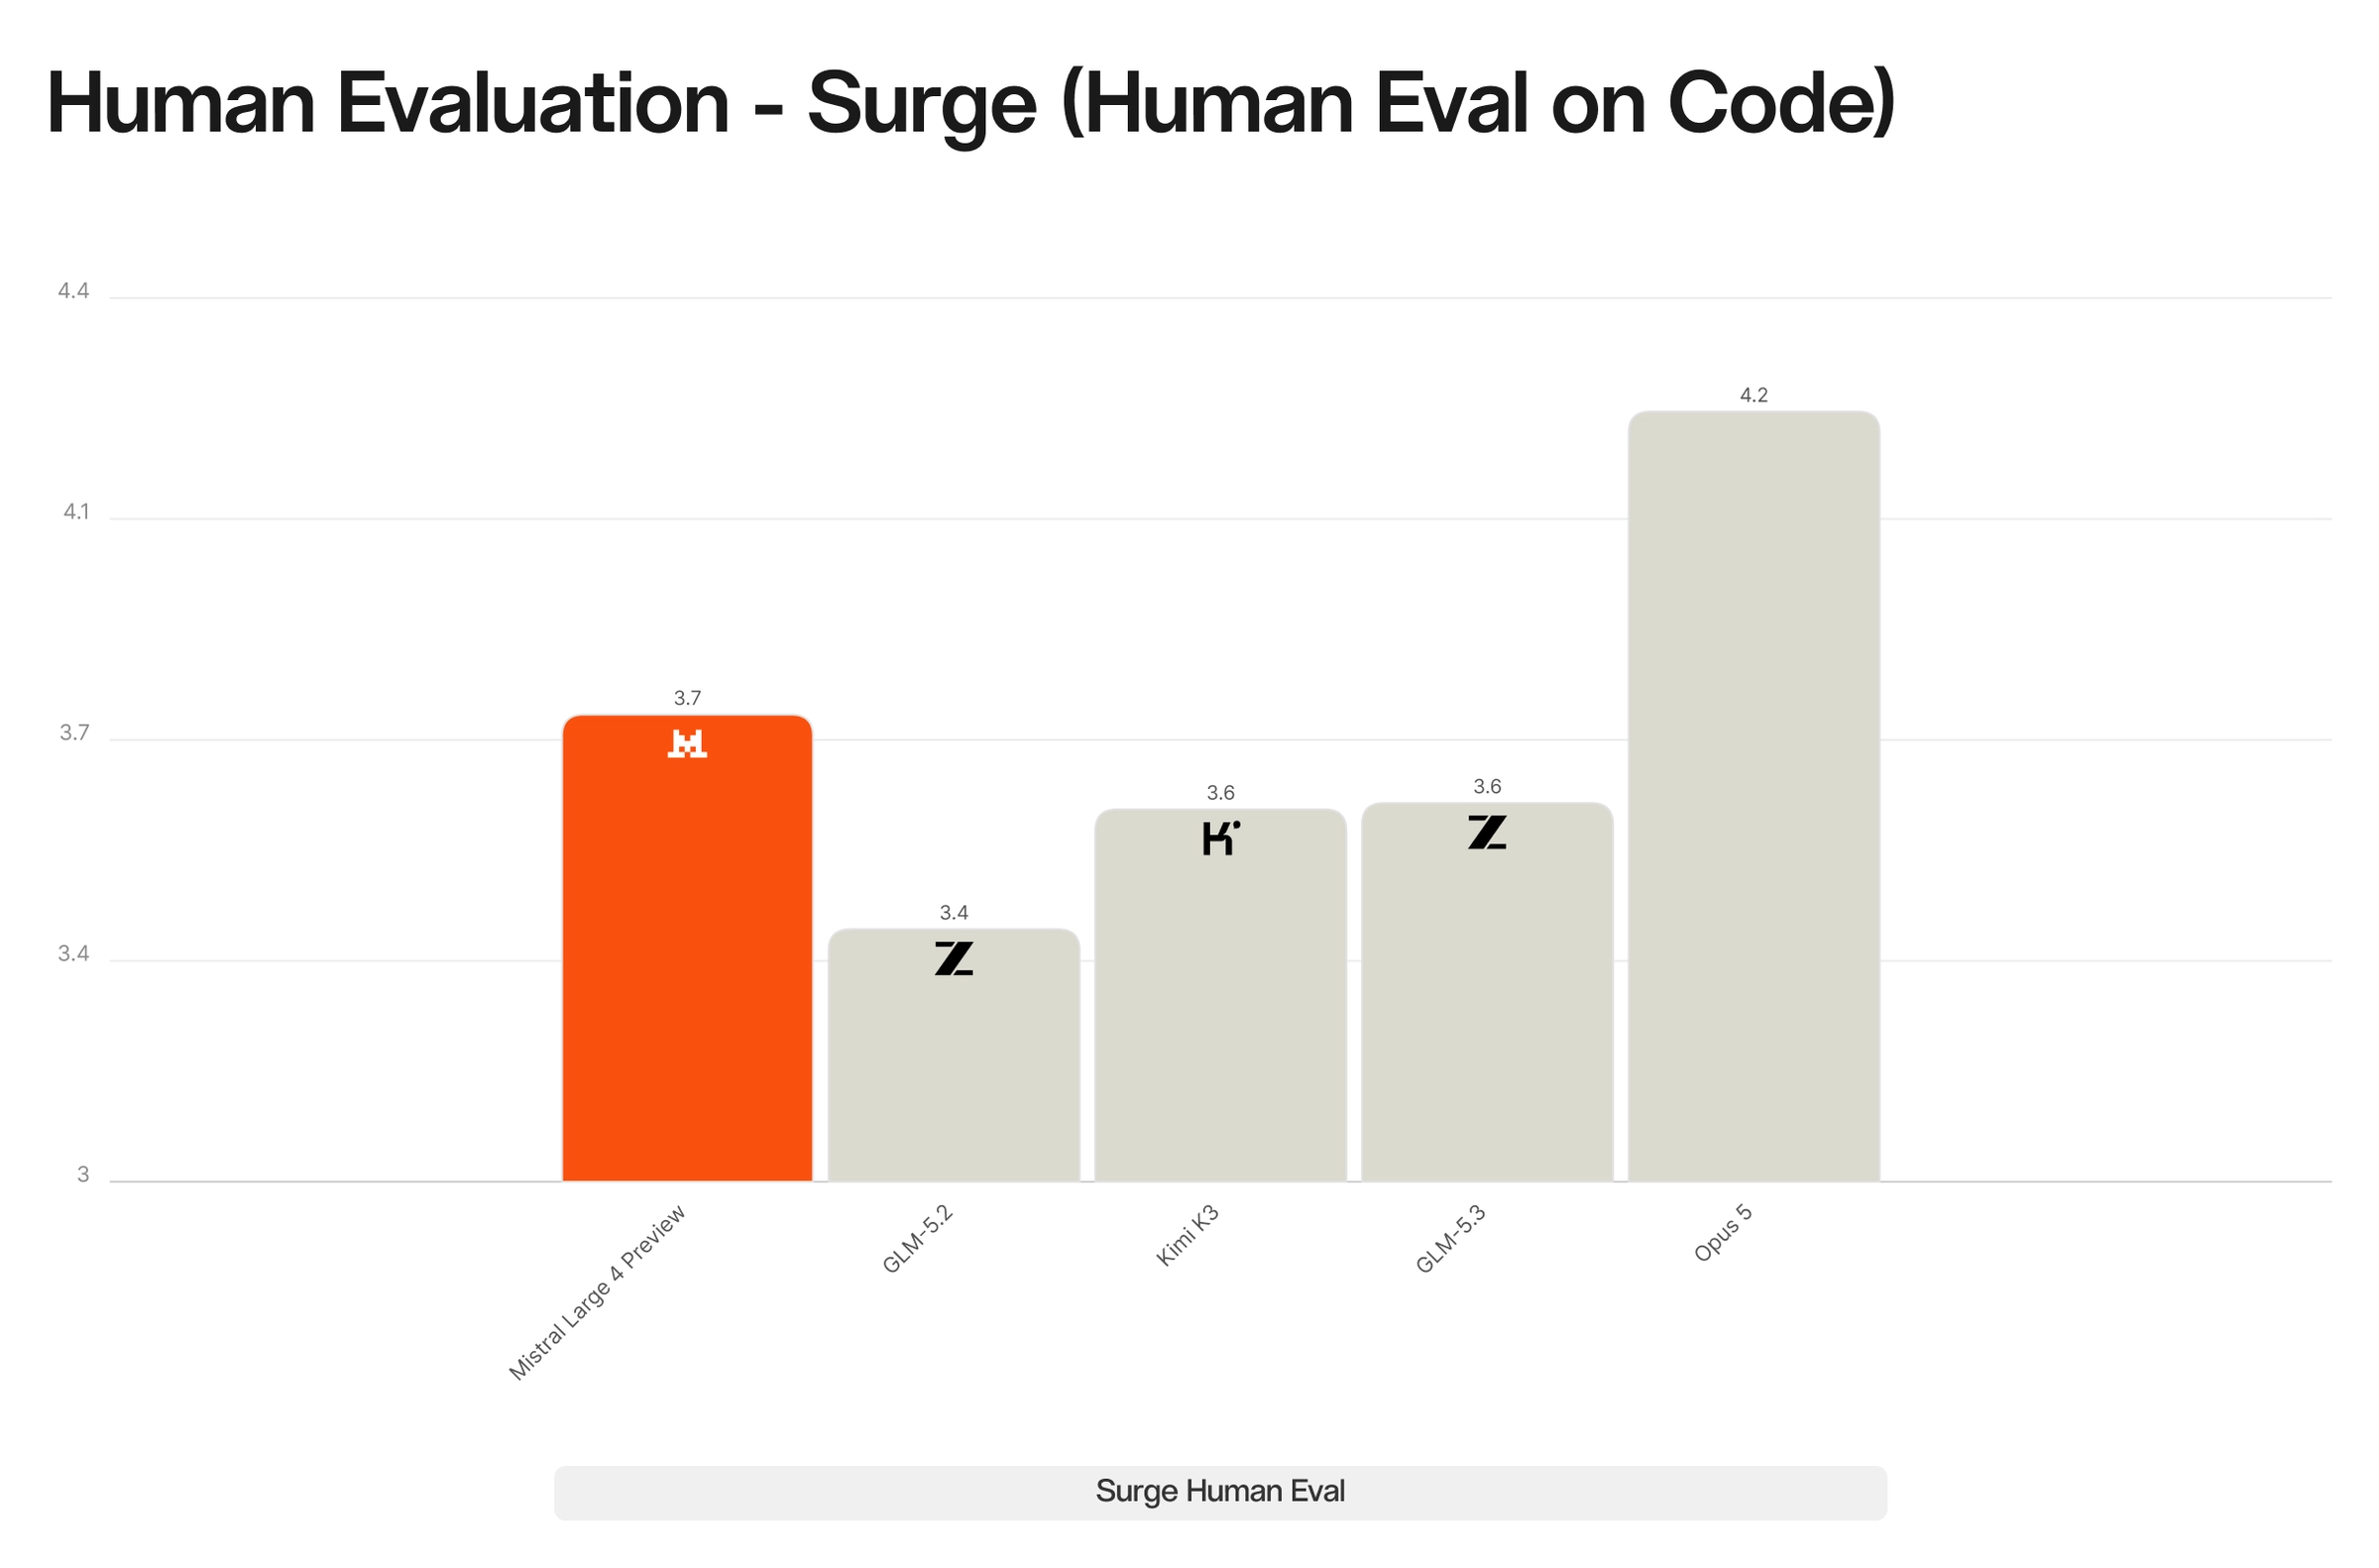
출처: Mistral AI 공식 발표 「Introducing Mistral Large 4」(2026-10-06). Surge AI 블라인드 인간 평가.
다만 아직은 vendor 발표 수치입니다. 가중치가 풀리고 독립 재현이 돌기 전까지는 "방향"으로 읽는 것이 맞습니다.
CodeBridge Mini Lab: 같은 workload로 5개를 재보자
브리핑의 액션을 그대로 실험 형태로 바꿔보겠습니다. 벤치마크 점수 비교가 아니라, 내 workload에서의 task 성공률 비교입니다.
① workload 1개를 고정한다 (예: repo 이슈 10개 수정)
② 같은 하네스·같은 tool·같은 제한시간으로 돌린다
③ 모델만 바꿔서 다음 5개를 기록한다:

   [ ] task 성공률 (테스트 통과 기준)
   [ ] wall-clock latency (task당 분)
   [ ] token 사용량 (입력 / 출력 / 캐시 히트)
   [ ] tool calling 성공률 (호출 중 유효 호출 비율)
   [ ] 1M-context 사용 시 비용 (긴 입력 3건 이상 포함)
④ 여기서 active compute당 성공률(성공 1건당 비용)을 계산한다
이 표를 채우면 "1조 모델이냐 아니냐"는 질문이 자연스럽게 사라집니다. 남는 질문은 하나입니다.
같은 일을 얼마나 적은 활성 계산으로 해내는가?
결론: 총량이 아니라 킬로와트당 일감으로 보자
Mistral Large 4가 가리키는 방향은 선명합니다.
과거 질문: 누가 가장 큰 모델을 가졌는가?
지금 질문: 같은 agent task를 얼마나 적은 active compute로
           풀어내는가?
1.05T의 capacity를 깔아두고 49B로 일하는 구조, 코딩·사이버·금융·제조 같은 전문 workload를 한 모델에 넣으려는 시도, 유럽 인프라에서 직접 서빙하는 주권형 운영까지. "큰 모델"이 아니라 "일하는 방식"을 파는 모델에 가깝습니다.
짧고 굵은 다음 행동은 하나입니다. preview API로 내 repo 이슈 5개만 돌려보고, 성공 1건당 토큰·시간·비용을 적어보세요. 그 숫자 하나가 벤치마크 표 열 개보다 정확합니다. 가중치가 풀리는 10월 말에는 같은 하네스로 로컬 서빙 비용까지 붙여보면 오픈웨이트의 진짜 단가가 보입니다.
함께 읽으면 좋은 글
참고 자료
- Mistral AI: Introducing Mistral Large 4 (Oct 6, 2026)
- Mistral Docs: Mistral Large 4
- Hugging Face: Mistral-Large-4.0-1T05-A52B
이 주제를 직접 따라가며 배우고 싶다면
모델을 고르는 눈과 에이전트 하네스를 엮는 연습이 필요하다면, 평가 지표·루프·그래프 구조를 손으로 쌓는 과정이 이 글의 Mini Lab과 바로 이어집니다.