10월 5일, Reflection AI가 첫 오픈웨이트 모델 Beam을 공개했습니다. 숫자는 이렇습니다.
Total:  501B parameters (sparse MoE)
Active: 23B parameters per token
Context: 1M tokens (mid-training에서 확장)
Modality: text-only
Mistral Large 4와 쌍을 이루는 흐름입니다. 질문이 "누가 더 크냐"에서 "같은 코딩 일을 얼마나 적은 활성 계산으로 하느냐"로 넘어가고 있습니다. Beam은 그 질문에 가장 정면으로 답한 모델입니다.
다만 지금은 수치의 출처를 정확히 해야 합니다. Beam은 final red-teaming 단계이며 가중치·technical report·model card·developer artifacts는 10월 중 공개 예정입니다. 아래 성적은 전부 vendor 자체 평가입니다.
무엇에 특화된 모델인가?
Beam은 처음부터 코딩·reasoning·agentic workload용으로 설계됐습니다. 범용 챗봇을 잘하는 모델이 아니라, 기업 코딩과 에이전트 일감을 싸게 돌리는 "workhorse"를 표방합니다.
Reflection이 공개한 대표 성적입니다.
SWE-bench Verified      80.9
SWE-bench Pro v2-Hard   77.2
SWE-bench Pro v1        65.5
SWE-bench Multilingual  78.0
Terminal-Bench v2.1     80.1
DeepSWE v1.1            44.4
SWE Atlas Codebase QnA  34.6
MCP Atlas               78.7
GPQA Diamond            90.5
AIME 2026               97.8
HLE (no tools)          36.2
코딩 벤치마크 비교 글의 렌즈로 읽으면 각 숫자의 의미가 갈립니다. SWE-bench 계열은 기존 repo의 이슈를 고치는 능력, Terminal-Bench는 터미널 환경에서 끝까지 일을 수행하는 능력, MCP Atlas는 외부 도구를 엮는 능력입니다. Beam은 이 세 축을 동시에 노린 구성이지, 어느 하나만 찍은 모델이 아닙니다.
솔직한 위치도 함께 공개됐습니다. GLM-5.2와는 대등하고 Qwen 3.8-Max에는 근접하지만, Kimi K3 같은 최상위 오픈 모델은 raw capability에서 Beam보다 앞섭니다. Beam의 승부처는 그 윗줄이 아니라 이 문장입니다.
GLM-5.2급 reasoning을 3–4배 적은 추론 compute로 달성한다.
주장을 그림으로 보면 이렇습니다. 아래는 Reflection이 공개한 Figure 2로, DeepSWE·HLE·Terminal-Bench 2.1에서 점수 대비 생성 FLOPs를 그린 것입니다. Beam(짙은 녹색 곡선)이 왼쪽 위 — 적은 계산으로 높은 점수 — 에 붙어 있고, GLM-5.2(주황)나 Qwen 계열은 오른쪽에 있습니다.
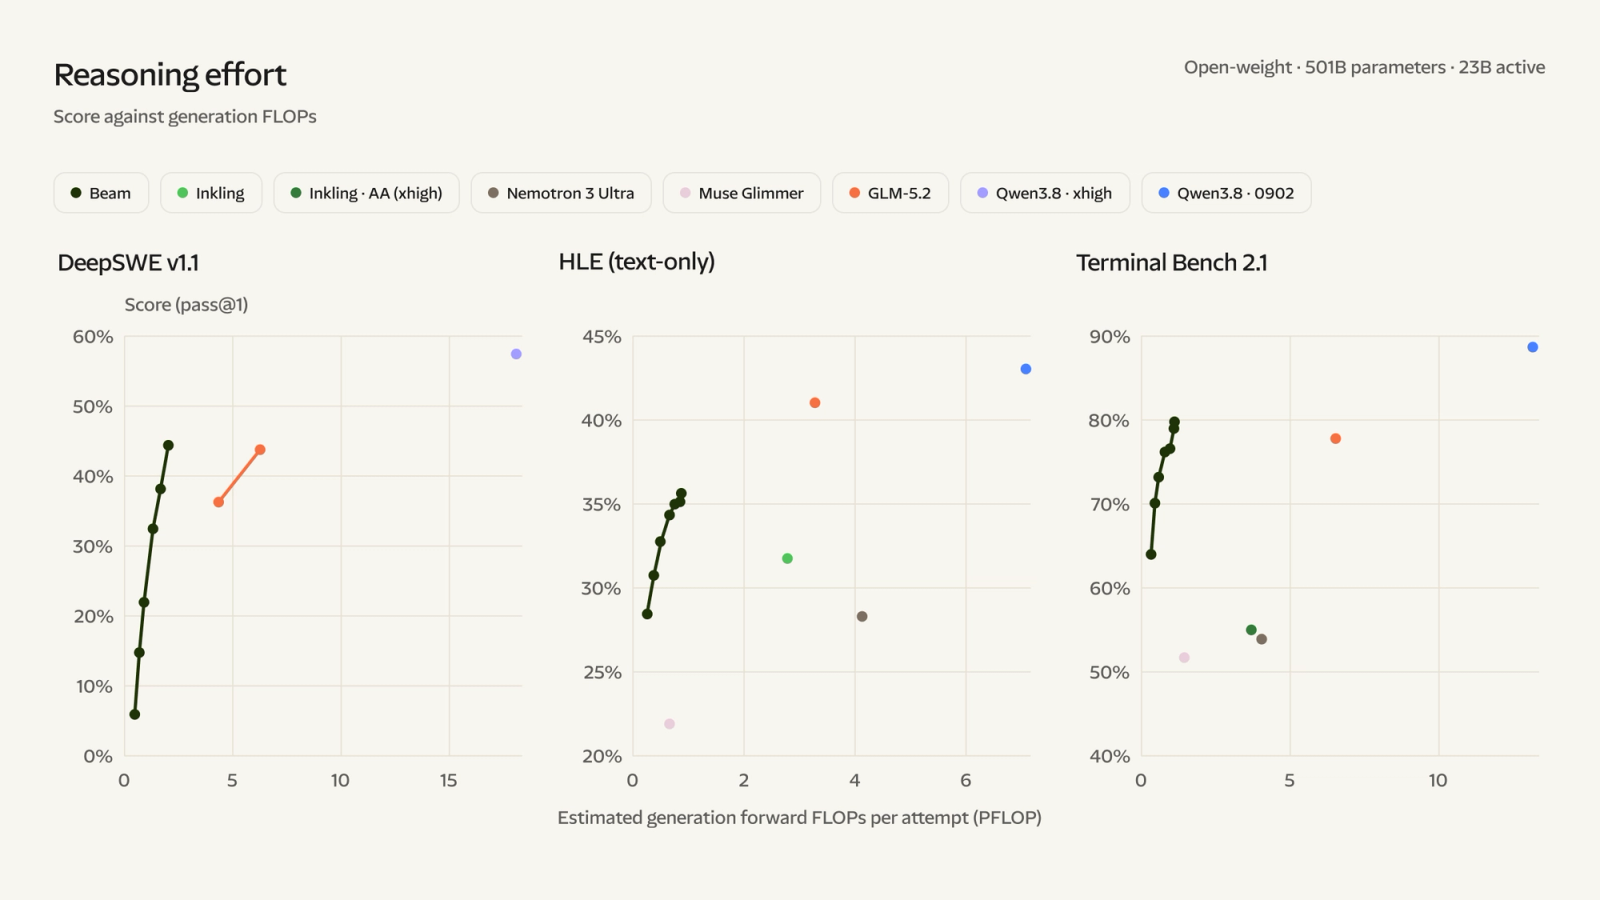
출처: Reflection 공식 발표 「Introducing Beam」(2026-10-05) Figure 2. 생성 FLOPs는 본문 근사식(FLOPs ≈ 2 × active params × 생성 토큰)으로 추정한 값이며 prefill·서빙 오버헤드가 제외된 추정치입니다.
10.5K GPU를 4주 돌린 이유: RL을 스케일 축으로 삼았다
Beam의 학습 규모는 pretraining보다 RL 쪽이 더 눈길을 끕니다.
Pretraining
- 23.8T 토큰 (웹·공개·라이선스 데이터, 코드 중심 큐레이션)
- 6,144 × GB300 NVL72, 4주 미만
- 52 layers, local+global interleaved attention
- fine-grained routed expert, near-uniform utilization

Mid-training
- 1M 컨텍스트 확장
- RL이 배우기 좋은 출발점용 데이터 파이프라인

High-compute RL (핵심)
- 10,500 × GB300, 4주
- 100M+ rollouts (최대 256K 컨텍스트)
- 약 1.3B sandbox 생성, 약 1M 환경
- 평균 110K 동시 rollout, 최대 170K 동시 sandbox
- fully asynchronous policy gradients
- 하루 묵은(107 버전 stale) 샘플에서도 안정 학습
"RL을 이렇게까지 돌린다"는 것의 의미는 단순합니다. 정답 데이터를 외우게 하는 것이 아니라, 에이전트가 직접 시도하고 실패하고 고치는 궤적 자체를 대량으로 생성해 학습했다는 뜻입니다. Reflection은 RL compute를 늘릴수록 점수가 계속 올랐고 plateau 조짐이 없었다고 합니다. 그 근거 그림(Figure 3)도 함께 공개됐습니다. rollout 수를 늘릴수록 DeepSWE·HLE·Terminal-Bench 점수가 우상향합니다.
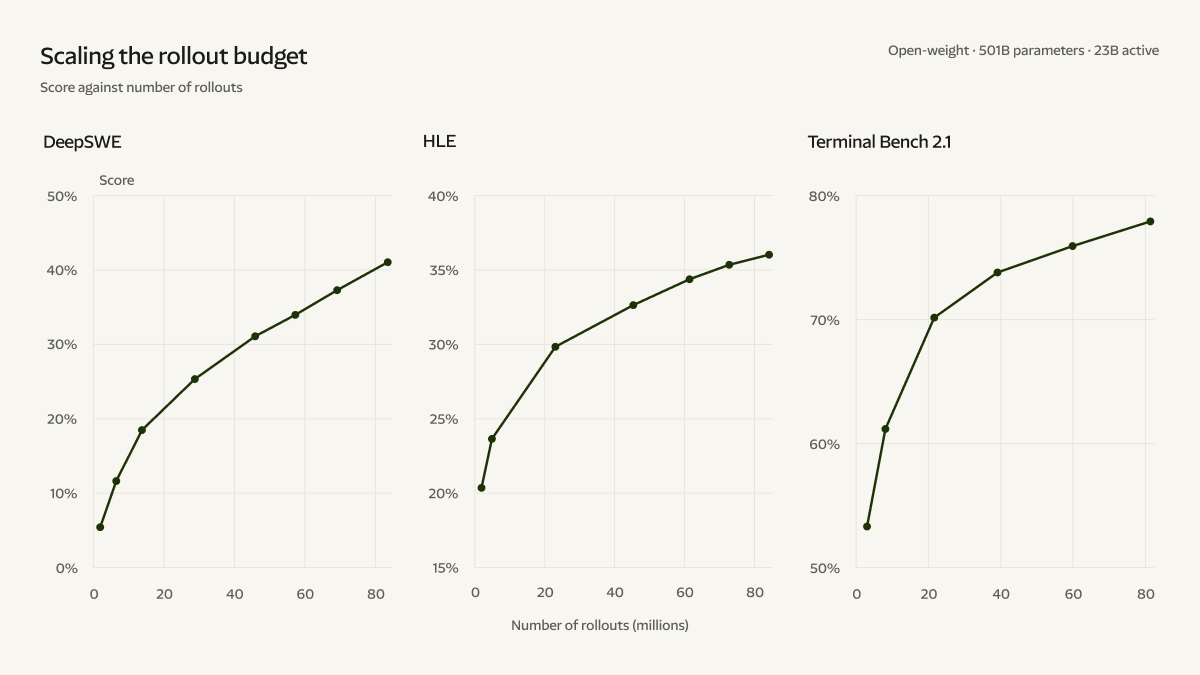
출처: Reflection 공식 발표 「Introducing Beam」(2026-10-05) Figure 3.
여기에 재미있는 장치가 하나 있습니다. 성공한 풀이에는 보상을 주되 불필요하게 긴 추론에는 패널티를 주는 length penalty로 토큰 효율을 먼저 가르쳤습니다. 사용자는 reasoning effort 파라미터로 "짧게·싸게"와 "길게·정확하게" 사이를 조절합니다. 이건 reasoning effort 글에서 다룬 트레이드오프가 제품 기능으로 들어온 사례입니다.
효율 주장, 어떻게 검증할 것인가?
Reflection의 효율 비교법은 논문에 적힌 근사식입니다.
FLOPs ≈ 2 × active params × mean generated tokens
dense가 아닌 MoE는 total이 아니라 토큰당 활성화 파라미터를 넣고, 생성 토큰에는 reasoning 과정까지 포함합니다. prompt prefill·attention·서빙 오버헤드는 제외된 근사치이므로 "측정된 비용"이 아니라 "계산량 비교용 추정치"로 읽어야 합니다.
그래서 가중치가 풀린 뒤의 올바른 검증은 FLOPs 논쟁이 아니라 실측입니다. 같은 코딩 하네스에서 Beam·GLM·Qwen·Kimi를 나란히 돌리고 다음 네 개를 재면 됩니다.
success  성공률 (동일 테스트 스위트)
tokens   task당 생성 토큰 (reasoning 포함)
clock    wall-clock 시간
memory   GPU 메모리 점유 (동일 양자화 기준)
이 실험이 좋은 포트폴리오 소재인 이유는 단순합니다. 벤치마크 표를 인용하는 사람은 많지만, 동일 하네스·동일 조건의 실측표를 가진 사람은 드뭅니다.
CodeBridge Mini Lab: 지금 당장 할 수 있는 준비
가중치가 없으니 모델 테스트는 못 합니다. 대신 하네스를 먼저 준비해두면 공개일에 바로 돌릴 수 있습니다.
# NOTE: 가중치 공개 후 실행할 비교 하네스 스케치
models = ["beam-501B-A23B", "glm-5.2", "qwen-3.8", "kimi-k3"]

results = {}
for model in models:
    results[model] = run_coding_harness(
        model=model,
        tasks="swe-verified-sample-20",  # 20개로 시작
        timeout_per_task="10min",
        record=["success", "tokens", "wall_clock", "gpu_memory"],
    )

# NOTE: 성공 1건당 비용으로 정렬 — 점수 순이 아니다
rank_by_cost_per_success(results)
지금 할 일:
① 20개짜리 고정 task셋을 만든다 (내 repo 이슈 기반 권장)
② 하네스·타임아웃·기록 항목을 고정한다
③ 가중치 공개일에 모델만 갈아끼운다
④ success / tokens / wall-clock / memory를 같은 표에 올린다
Apache 2.0 라이선스 약속도 공개일에 확인할 체크포인트입니다. LICENSE 파일에 Apache 2.0이 명시되는지, 메모리 요구량과 양자화 포맷이 model card에 기재되는지를 보면 됩니다.
결론: 무거운 한 방보다 가벼운 반복이 이기는 workload가 있다
Beam이 겨냥한 현실은 이렇습니다.
기업 코딩·에이전트 workload
= 어려운 문제 1개가 아니라
  중간 문제 수천 개를 매일 돌리는 일
이런 workload에서는 한 문제의 최고 점수보다 성공 1건당 비용이 전체 예산을 결정합니다. 23B active로 GLM-5.2급을 내는 모델이 있다면, 같은 예산으로 3배의 시도를 돌릴 수 있습니다. 시도 횟수가 곧 커버리지가 되는 영역에서는 효율이 곧 능력입니다.
짧고 굵은 고민거리를 남기면: 여러분 팀의 코딩 일을 "어려운 10문제"가 아니라 "월 1,000건의 반복 작업"으로 다시 세어보세요. 그 표에서 Beam 같은 효율형 모델의 자리가 보인다면, 가중치 공개일에 돌릴 하네스를 오늘 준비해두는 것이 가장 빠른 대비입니다.
함께 읽으면 좋은 글
참고 자료
이 주제를 직접 따라가며 배우고 싶다면
코딩 에이전트를 하네스째로 이해하고 동일 조건 비교 실험을 돌리는 연습이 필요하다면, Claude Code·서브에이전트·MCP를 실제 프로젝트에 쌓는 과정이 이 글의 Mini Lab과 바로 이어집니다.