
10월 8일, OpenAI가 GPT-6.1 Sol에 Ultrafast 모드를 붙였습니다. 새 모델이 아니라 같은 모델의 고속 처리 방식입니다. Responses API에서 service_tier를 ultrafast로 두면 됩니다. API와 Codex, ChatGPT Work에 함께 rollout됐습니다.
가격은 Standard의 6배입니다. 짧은 문맥 기준으로 입력 100만 토큰당 $12, 출력 100만 토큰당 $60입니다. Standard가 입력 $2와 출력 $10이니 정확히 6배입니다. 빠른 응답이 중요한 실시간 서비스에 맞을 수 있다는 게 공식 안내의 표현입니다.
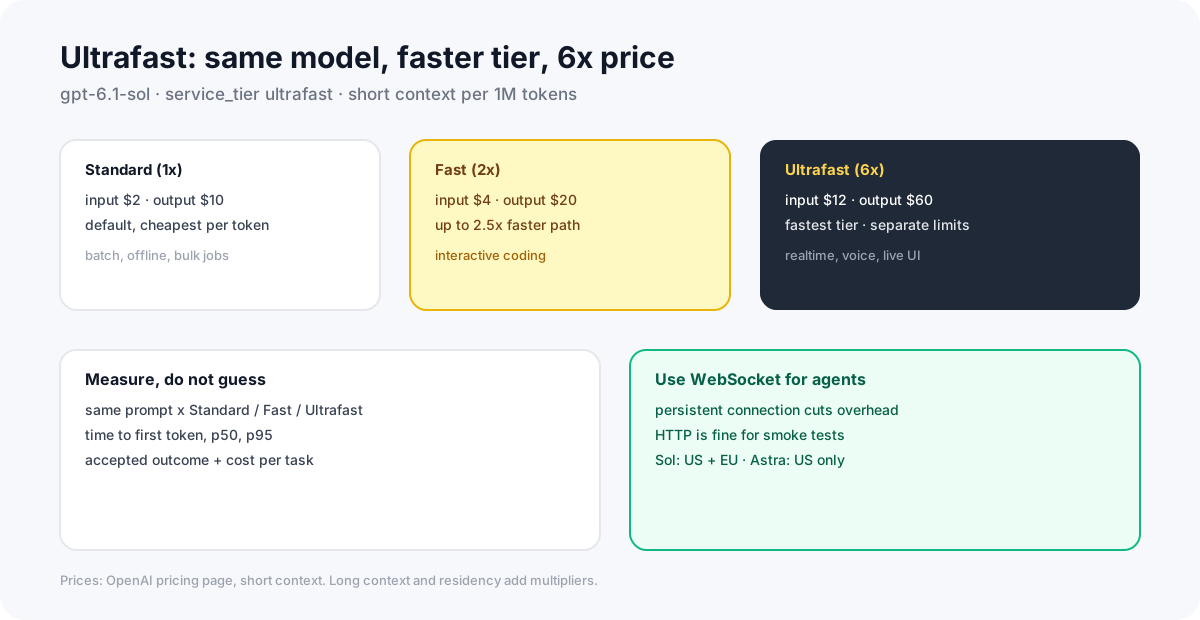
위 그림이 오늘 글의 전부입니다. 같은 모델, 다른 티어, 다른 요금. 고를 기준은 속도 체감이 아니라 측정입니다.
설정은 한 줄: service_tier를 ultrafast로
바꾸는 건 모델 ID가 아니라 처리 방식입니다. 모델은 gpt-6.1-sol 그대로 두고 요청마다 티어를 고릅니다. GPT-6 Astra도 Ultrafast를 씁니다.
from openai import OpenAI

client = OpenAI()

response = client.responses.create(
    model="gpt-6.1-sol",
    input="Explain empty-value handling in a Python form.",
    service_tier="ultrafast",
)

print(response.output_text)
print(response.service_tier)
print(response.usage)
응답의 service_tier를 꼭 확인하세요. 프로젝트 기본값이나 지역, 한도 때문에 다른 티어로 처리될 수 있고, 실제 처리된 티어 기준으로 과금되기 때문입니다. 지원되지 않는 지역으로 고정하면 Standard로 떨어집니다.
에이전트처럼 도구 호출이 잦은 작업에서는 persistent WebSocket 연결이 권장됩니다. 매 턴마다 연결을 새로 만들면 네트워크 오버헤드가 추론 이득을 갉아먹기 때문입니다. HTTP도 지원되니 기본 동작은 HTTP로 확인하고, 잦은 호출 구조에서는 WebSocket으로 시간을 재보세요.
요금표: 6배가 정확히 얼마인가
공식 가격표의 짧은 문맥, 즉 입력 27만 2천 토큰 이하 기준입니다.
| 모델 | Standard 입력 / 출력 | Fast 입력 / 출력 | Ultrafast 입력 / 출력 |
|---|---|---|---|
| GPT-6.1 Sol | $2 / $10 | $4 / $20 | $12 / $60 |
| GPT-6 Astra | $10 / $50 | $20 / $100 | $60 / $300 |
Fast는 Standard의 2배, Ultrafast는 6배입니다. 캐시 입력과 캐시 쓰기에도 각 티어 요율이 따로 있습니다. 긴 문맥과 지역 처리는 할증이 붙습니다. 지역 고정은 Sol이 미국과 유럽, Astra가 미국만 됩니다. 글로벌 처리는 둘 다 됩니다.
한도도 따로입니다. Ultrafast는 Standard나 Fast와 속도 제한을 공유하지 않습니다. Sol 기준 분당 토큰 기본값이 Build 100만, Launch 400만, Grow 4,000만입니다. Astra는 Build 50만, Launch 100만, Grow 500만으로 더 작습니다. 트래픽을 올리기 전에 조직 한도를 먼저 확인하세요. 필요하면 계정팀에 증량을 요청해야 합니다.
Codex와 ChatGPT Work 쪽 얘기도 덧붙입니다. API 과금과 구독형 entitlements는 규칙이 다릅니다. 발표에서는 Codex에서 Standard 대비 최대 8배 빠른 토큰 생성을 언급했습니다. 구독 화면의 체감과 API 요금을 같은 표에 두면 안 됩니다.
언제 Ultrafast인가: 실시간일 때만
모델 성능이 같더라도 추론 속도에 추가 비용을 내는 시장이 생기고 있습니다. 그래서 질문이 바뀝니다. 어떤 모델이냐가 아니라, 언제 빠른 티어를 쓰느냐입니다.
Ultrafast를 먼저 의심해볼 때:
- 첫 토큰이 늦으면 이탈이 생기는 실시간 UI와 음성
- 짧은 왕복이 쌓이는 코딩 반복과 라이브 지원
- 사람이 기다리는 한 번의 응답

Standard가 맞는 때:
- 배치와 오프라인, 대량 작업
- 재시도와 검증이 붙는 긴 에이전트 작업
- 출력 토큰이 커서 6배가 그대로 곱해지는 작업
토큰당 속도가 아니라 작업당 시간과 비용으로 봐야 합니다. 출력이 긴 작업은 6배가 그대로 붙습니다. 스트리밍으로 첫 토큰 시간을 따로 재고, 끝까지의 시간과 함께 보세요. 논스트리밍 예제는 완료 시간만 재서 첫 반응을 놓칩니다.
CodeBridge Mini Lab: 같은 요청으로 세 티어를
브리핑의 실무 액션 그대로, 같은 요청으로 Standard와 Ultrafast를 붙이세요.
1. 같은 프롬프트와 effort, 도구, 데이터로 default, fast, ultrafast를 각 2회 이상
2. 기록: time to first token, model duration, tool duration, end to end
3. 품질: 채택 여부와 재작업 시간, 실패와 수동 수정
4. 집계: p50과 p95, 완료당 비용
5. 확인: response의 실제 티어와 usage, 프로젝트 기본 라우팅
HTTP 응답 200이 채택된 결과가 아니라는 점이 중요합니다. 작업 ID별로 티어와 토큰, 시간, 채택, 재작업 분을 한 행에 두면 Ultrafast가 진짜로 돈을 버는지 보입니다. 속도 제한과 재시도 처리도 피크에서 같이 시험하세요.
모델 속도 가이드의 첫 반응과 무거운 분석 나누기와 함께 보면 좋습니다. 비용 잣대는 성공 1건당 비용 글과 Sol과 Astra 비교 글에서 이어집니다.
결론: 빠르게 만드는 게 아니라 기다림을 줄이는 것
한 줄로 정리합니다.
같은 모델이라도 티어는 다르다. 빠른 티어는 토큰이 아니라 기다림을 사는 선택이다.
Ultrafast는 만능 가속이 아니라 실시간용 옵션입니다. 6배 요금이 아깝지 않은 기다림 하나를 찾고, 같은 요청으로 세 티어를 재보세요. 응답 시작 시간과 p95, 완료당 비용이 말해주는 대로 고르면 됩니다.
함께 읽으면 좋은 글
- AI 모델 속도: 지연시간을 읽는 법
- GPT-6.1 Sol vs GPT-6 Astra: 최고 모델보다 Cost per Task가 중요한 이유
- AI 모델 비용은 성공 1건당 비용으로 봐야 한다
참고 자료
- OpenAI API Changelog: Added Ultrafast mode for GPT-6.1 Sol (2026-10-08)
- OpenAI: Ultrafast mode guide
- OpenAI: GPT-6.1 Sol model page
- OpenAI: API pricing
- OpenAI Developer Community: Ultrafast is rolling out today for GPT-6.1 Sol (2026-10-08)
- OpenAI: Introducing GPT-6.1 Sol
- Vercel Changelog: OpenAI Ultrafast mode now available on AI Gateway (2026-10-08)
- Code0: GPT-6.1 Sol Ultrafast speed, task time, and total cost (2026-10-08)
이 주제를 직접 따라가며 배우고 싶다면
빠른 첫 반응과 무거운 분석을 나누는 설계는 에이전트의 실행 구조를 이해할 때 쉬워집니다. 작업을 쪼개고 검증하는 연습이 필요하다면, 다섯 단계를 쌓는 과정이 이 글의 속도 패턴과 바로 이어집니다.