9월 30일 Kiro가 Workflows를 공개했습니다. IDE·CLI·Web 공통 런타임, opt-in 기능, 재사용 가능한 recipe. 한 문장으로 줄이면 이렇습니다.
복잡한 일을 하나의 긴 세션이 아니라, 여러 에이전트 세션으로 나눈 파이프라인으로 돌린다.
코딩 에이전트의 다음 단계가 어디인지를 보여주는 상징적인 릴리스입니다. 더 긴 prompt가 아니라 SPEC → 구현 → 독립 리뷰 → 수정 → PR을 명시적인 graph로 고정하는 쪽으로 가고 있습니다.
핵심 아이디어: step마다 fresh context
Workflows는 step·sequence·loop·parallel 분기로 이뤄진 graph입니다. 규칙 다섯 개만 잡으면 전체가 읽힙니다.
Step      에이전트 1개가 자기 세션에서 돈다
Handoff   앞 step의 결과만 {{...}} 변수로 다음 step에 전달
Branch    독립 리뷰처럼 나란히 돌리고 join 정책으로 합친다
Loop      승인 조건이 맞을 때까지 반복 (최대 횟수 cap 포함)
Wait      PR·배포 같은 외부 상태를 model turn 소모 없이 기다린다
가장 중요한 문장은 이것입니다.
각 step은 자기 세션의 fresh context에서 돌고, 이전 step이 넘긴 정보만 받는다.
왜 이렇게 만들었을까요? 하나의 context window에 계획·tool output·추론을 전부 쌓으면 세션이 길어질수록 agent가 plan을 잃기 때문입니다. Kiro는 이 한계를 "더 큰 window"가 아니라 "workflow orchestration"으로 풀었습니다. 리뷰어는 구현자의 reasoning을 물려받지 않으니 진짜 독립 리뷰가 됩니다.
실행 중에도 손을 댈 수 있습니다. step별 agent·model·effort·tool activity가 보이고, pause/resume/retry/steer와 단계별 메시지, step이 질문하면 멈추고 답을 기다리는 ask-and-wait까지 됩니다. run 상태는 node 경계에서 checkpoint되니, 끊겨도 처음부터 다시 돌릴 필요가 없습니다.
번들 레시피 3개: investigate · feature-pipeline · publish-pr
Kiro 팀이 매일 직접 쓴다는 기본 제공분입니다.
investigate
→ 읽기 전용 단일 에이전트 조사, background 실행
→ 메인 세션의 context를 더럽히지 않고 보고서로 복귀
→ "일단 알아보고 와"를 시키는 용도

feature-pipeline
→ 요구사항 → 설계·리뷰 → 계획 → 구현 →
   병렬 독립 리뷰 → 최종 검증
→ 설계·코드 loop는 최대 3회, 미승인 시 중단
→ 기능 배송의 정석 파이프라인

publish-pr
→ PR 열고 CI 실패 재시도·리뷰 피드백 대응
→ 설계 변경·범위 확장·UX 변경 전에는 질문
→ merge까지 끌고 가는 마무리 파이프라인
레시피는 JSON·YAML로 사람이 읽고 agent도 읽는 형태라, "Kiro에게 말로 시켜서 생성 → 저장 → 재사용" 흐름이 됩니다. .kiro/workflows/에 두면 IDE·CLI·Web 어디서든 같은 파일이 돕니다.
실제 실행 화면을 보면 파이프라인의 맛이 납니다. 아래는 Kiro 공식 발표에 실린 Workflows 실행 화면으로, auth/session 리팩터 작업이 setup-worktree → investigate → plan → build-loop(최대 3회, iteration 2 진행 중) → dual-review 병렬 → aggregate → validate 순서로 돌고, 각 step의 agent·model·effort·소요시간이 트리로 표시됩니다. 왼쪽에는 완료 보고와 PASS 판정이, 오른쪽에는 step별 실행 결과가 가지런히 놓여 있습니다.
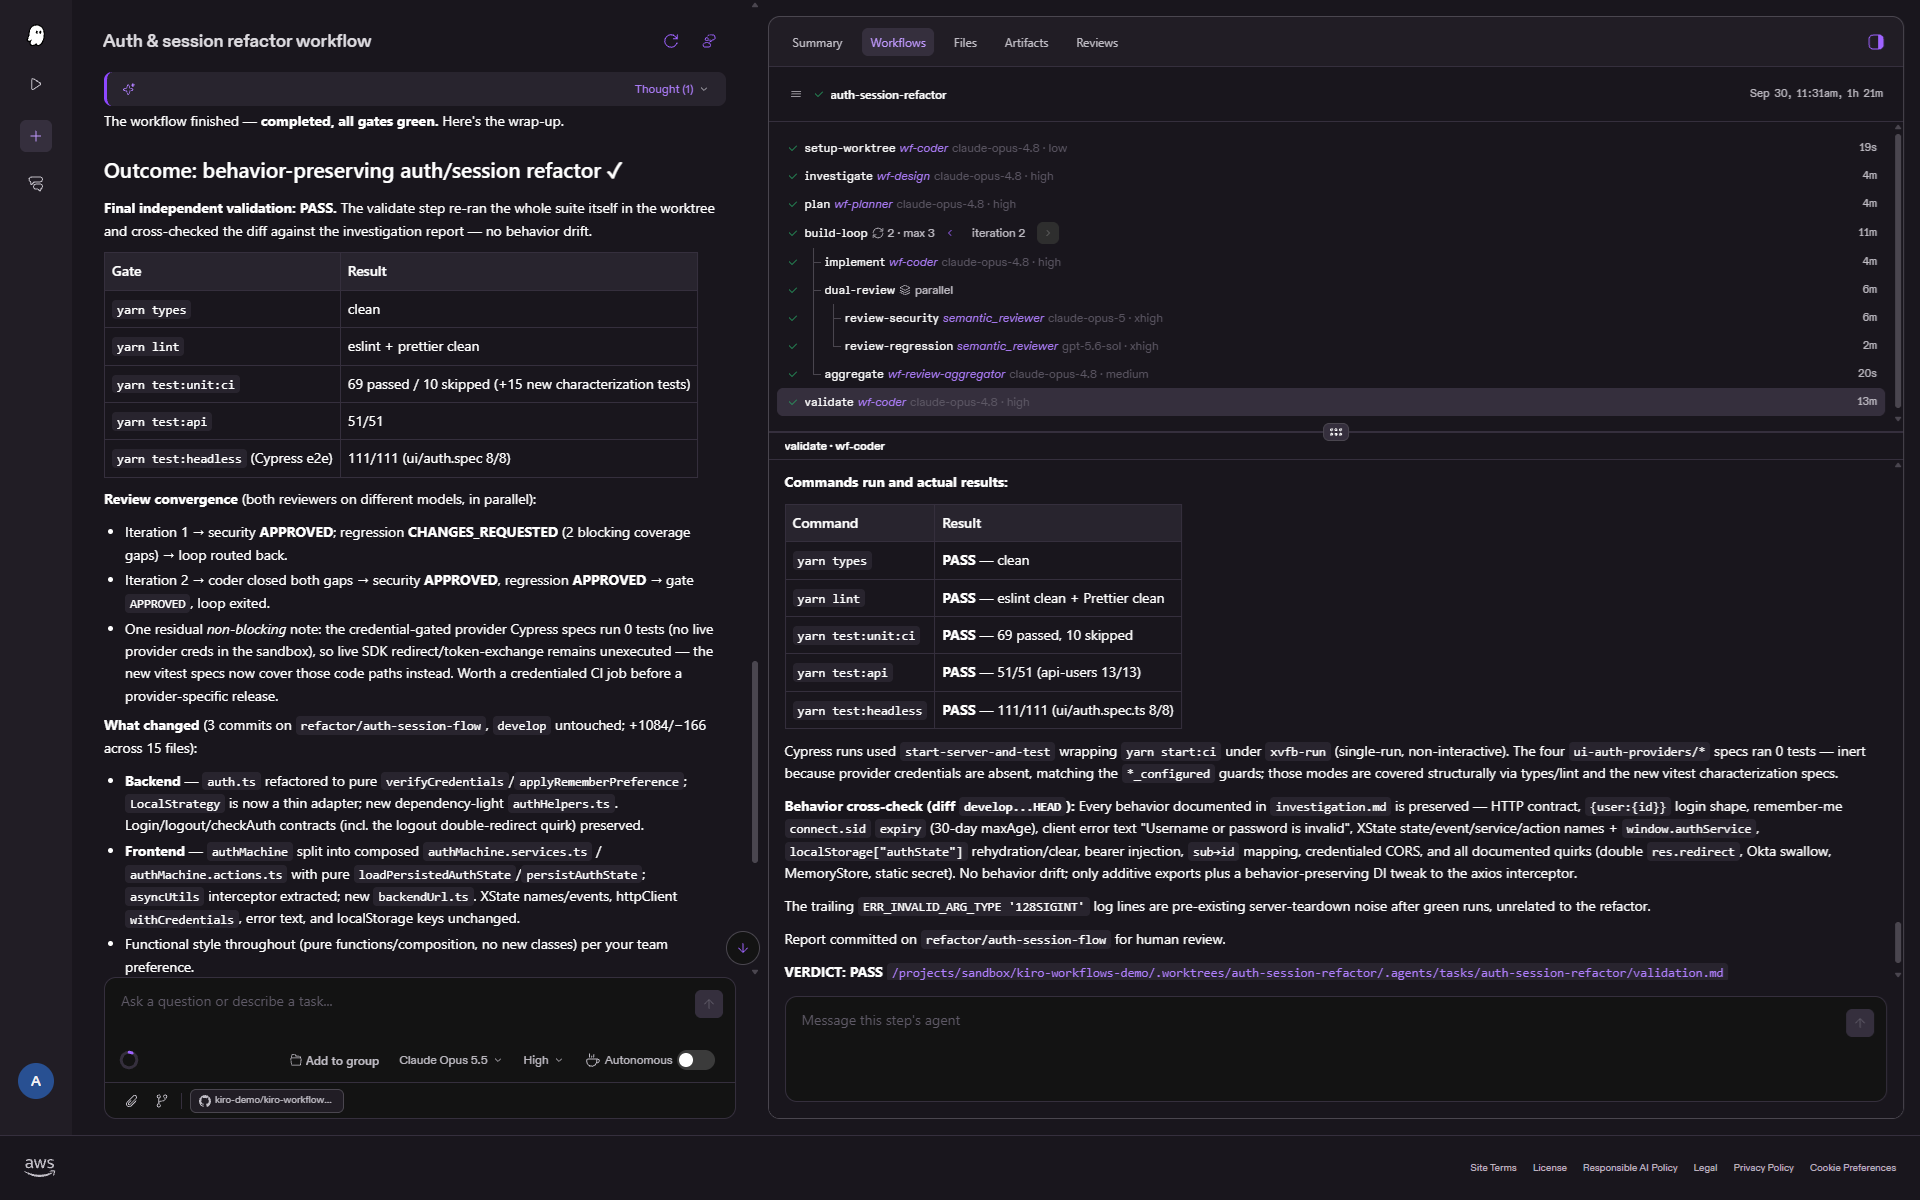
출처: Kiro 공식 발표 「Introducing Kiro workflows」(2026-09-30). auth/session 리팩터 실행 예시.
한계도 문서에 명시돼 있습니다. 최대 8단계 nesting·50개 step, repeat마다 최대 반복 필수, Git 브랜치 격리·worktree 생성은 자동이 아니라 사용자가 설계해야 합니다. 동시 실행이 같은 checkout을 건드리면 덮어쓰니 run별 run_dir·artifact 경로 분리와 worktree 분리가 권장됩니다.
서브에이전트와 뭐가 다른가?
헷갈리기 쉬운 지점이라 표로 둡니다.
서브에이전트 (invoke_sub_agent)
→ 메인 에이전트가 그때그때 시키는 위임
→ 구조는 프롬프트·세션 안에 암묵적으로 존재

Workflows (run_workflow)
→ runtime이 소유하는 명시적 구조
→ step·handoff·loop·wait·복구가 1급 시민
→ 백그라운드 실행 + inspect + checkpoint
Workflows를 켜면 메인 세션의 위임도 run_workflow로 라우팅되고, 단일 커스텀 에이전트 1개를 background로 띄우는 것도 1-step workflow가 됩니다. step 안의 에이전트가 자기 서브에이전트를 쓰는 것은 허용되지만, 그 서브에이전트는 workflow node가 아니라 step 내부 일꾼으로 취급됩니다.
CodeBridge Mini Lab: 4-step 파이프라인 vs single-agent
브리핑의 액션을 실험으로 옮기면 이렇습니다. 복잡한 feature 하나를 두 방식으로 돌려 실패율을 비교하세요.
방식 A (single-agent):
  "이 기능 구현하고 테스트까지 해줘" 1문장 지시

방식 B (4-step workflow):
  ① implement  기능 구현 + 관련 테스트 실행
  ② test      테스트 결과 검증 (통과 증거 요구)
  ③ review    독립 리뷰 (구현 reasoning 공유 금지,
              발견 사항 문서화)
  ④ fix       리뷰 지적 반영 + 재검증

고정 조건: 같은 모델, 같은 repo, 같은 제한시간
기록 항목:
  [ ] 기능 완성 여부 (human 판정)
  [ ] 리뷰가 잡은 결함 수 (방식 A는 사후 리뷰로 계수)
  [ ] 총 token·크레딧 사용량
  [ ] 중간 개입 횟수 (steer·재시도)
기대 결과는 대개 이렇습니다. 방식 B가 token은 더 쓰지만, 결함 유출과 "처음부터 다시" 빈도는 낮아집니다. 이 트레이드오프를 숫자로 가진 팀이 파이프라인 투자를 정당화할 수 있습니다.
처음부터 거창하게 시작할 필요는 없습니다. investigate 레시피로 읽기 전용 조사 1건을 background로 시켜보세요. 메인 세션 context가 깨끗하게 남는 경험을 하면, 왜 step 분리가 필요한지 몸으로 이해됩니다.
결론: 프롬프트 엔지니어링 다음은 파이프라인 엔지니어링이다
정리하면 흐름은 이렇습니다.
1단계: 좋은 prompt를 쓰는 경쟁
2단계: 좋은 agent(모델+하네스)를 쓰는 경쟁
3단계: 좋은 pipeline(명시적 graph+독립 리뷰+게이트)을
       설계하는 경쟁  ← 지금 여기
하네스 글에서 말한 "AI를 잘 쓰는 것 다음"이 제품 기능으로 들어온 사례입니다. 루프와 그래프 개념을 레시피 파일로 저장·재사용할 수 있게 된 것이기도 합니다.
짧고 굵은 다음 행동은 하나입니다. 이번 주 작업 하나를 implement → test → independent review → fix 네 칸으로 나눠보세요. 리뷰 step에는 구현 과정을 절대 공유하지 마세요. 그 한 줄의 분리가, 여러분 팀의 에이전트 실패율을 얼마나 낮추는지 직접 확인해보세요.
함께 읽으면 좋은 글
참고 자료
- Kiro: Introducing Kiro workflows (Sep 30, 2026)
- Kiro Docs: Workflows
- Kiro Docs: Workflow examples
- Kiro Web: Introducing Workflows
이 주제를 직접 따라가며 배우고 싶다면
멀티스텝 파이프라인·독립 리뷰·검증 게이트를 손으로 설계하는 연습이 필요하다면, 하네스·루프·그래프를 쌓는 과정이 이 글의 4-step 실험과 바로 이어집니다.