
AI 에이전트 운영의 중심이 프롬프트 손보기에서 평가와 회귀 검증으로 옮겨가고 있습니다. 10월 7일 Kore.ai가 그 흐름에 이름을 붙였습니다. Autoloop. 에이전트 실행 결과를 계속 평가하고, 고치고, 다시 검증하는 최적화 엔진입니다. Agent Platform의 Artemis 에디션에서 정식 제공됩니다.
핵심 문장은 짧습니다. 목표를 정하면, Autoloop이 만들고 재고, 못 미치는 곳을 찾아 고치고, 검증된 것만 남긴다. 배포 전에도, 배포 후에도 같은 루프가 돕니다.
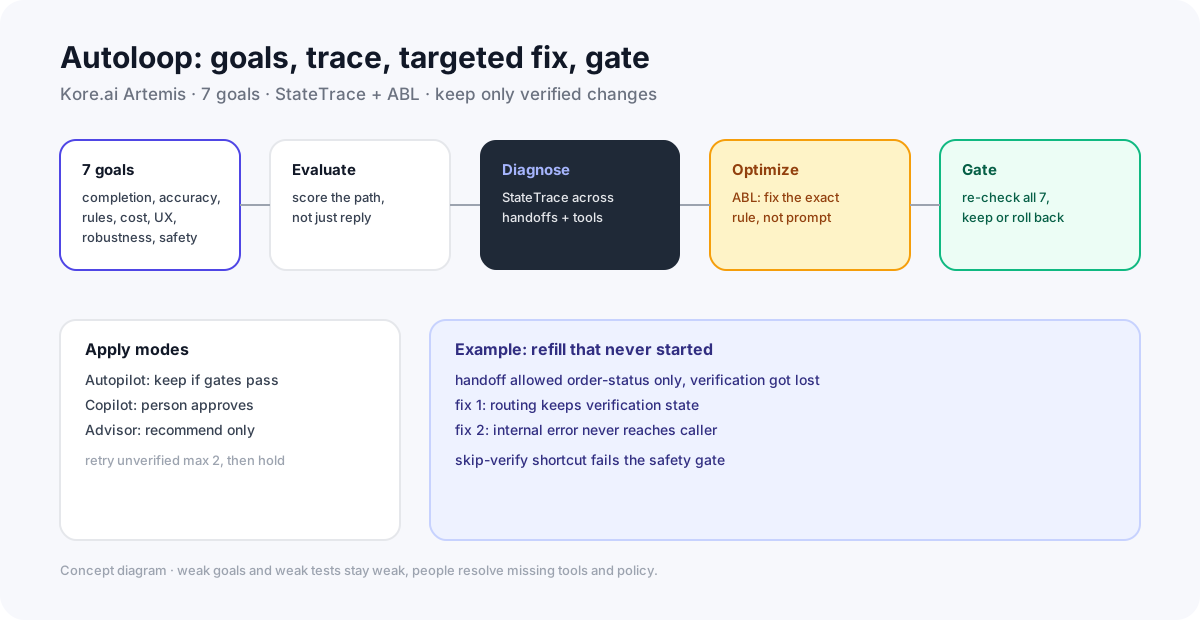
위 그림이 전체입니다. 목표가 기준이 되고, 흔적 추적이 원인을 찾고, 설계 언어가 정확한 위치를 고칩니다.
7가지 목표: 무엇을 잘함으로 칠 것인가
팀은 에이전트가 맞춰야 할 목표를 7개 차원으로 정합니다. 작업 완료와 정확도·근거, 업무 규칙 준수, 토큰·비용 효율, 사용자 경험, 강건성, 안전성입니다. 이 목표가 에이전트와 모든 변경을 재는 잣대가 됩니다.
한 차원만 올리고 끝이 아닙니다. 모든 변경은 7개를 함께 통과해야 남습니다. 토큰을 아꼈는데 작업 완료가 떨어지면 탈락입니다. 겉의 문장을 숨겼는데 실제 일이 안 끝나도 탈락입니다.
출시 전에는 운영 절차서에서 에이전트와 테스트 범위를 만들고 목표를 맞출 때까지 돌립니다. 배포 후에는 실제 상호작용이 새 사이클을 엽니다. 목표를 그대로 두고 계속 재는 겁니다.
실패는 답이 아니라 경로에서 찾는다: StateTrace
대부분의 고치기 루프는 같은 모양입니다. 평가하고, 모델에게 고치라고 하고, 다시 평가합니다. 단순한 실패에는 통하지만 시스템 깊은 곳에서는 어긋납니다. 점수가 떨어졌다는 건 방향만 알려줄 뿐, 어느 단계와 핸드오프, 도구, 상태가 원인인지 말해주지 않습니다. 프롬프트를 고치는 건 계약이나 픽스처, 라우팅 규칙이 문제일 때 빗나갑니다.
Autoloop은 실행 경로를 봅니다. Artemis 런타임이 에이전트 네트워크를 가로지르는 핸드오프와 상태 변화, 도구 호출, 컨텍스트를 전부 추적합니다. StateTrace가 그 흔적을 따라 목표를 놓친 위치와 이유를 찾습니다. 최종 답장이 아니라 지나온 길을 채점하는 겁니다. 결정적인 검사는 정해진 방식으로, 판단이 필요한 곳에만 모델을 쓰는 구조라 상시 최적화 비용도 낮췄다고 합니다.
대표 예시가 리필 실패입니다. 첫 에이전트는 회원을 확인했는데, 핸드오프 조건이 주문 상태 조회만 허용해서 확인 상태가 넘어가지 않았습니다. 리필은 시작도 못 했고 내부 문구가 호출자에게 노출됐습니다. 겉의 점수만 보면 한 문제 같지만, 원인은 둘이었습니다.
고치는 위치: ABL이 가리키는 그 부품
Artemis의 에이전트는 Agent Blueprint Language로 쓰이고 컴파일됩니다. 감독과 라우팅, 위임과 도구, 업무 규칙과 가드레일이 실행 가능한 상태 기계가 됩니다. 그래서 흔적의 한 걸음이 설계의 어느 부품에서 나왔는지 바로 연결됩니다.
위 리필 예시에서 수정은 두 군데였습니다. 확인된 회원의 리필 요청이 확인 상태를 달고 리필 경로에 닿도록 라우팅 규칙을 고치고, 내부 오류가 호출자에게 나가지 않도록 텍스트가 나가는 위치에서 막는 겁니다. 프롬프트에 한 줄 덧붙이는 방식이 아닙니다.
게이트도 빡빡합니다. 컴파일과 계약 완성, 시뮬레이션과 강건성, 행동 검증을 순서대로 오릅니다. 각 단계가 배포까지 무엇이 남았는지 가리킵니다. 검증 안 된 변경은 최대 두 번 다시 시도하고, 그래도 안 되면 롤백해서 사람에게 넘깁니다. 프로젝트는 그대로 보존됩니다.
적용 방식은 세 가지입니다. Autopilot은 게이트를 통과하면 자동으로 남기고, Copilot은 사람이 승인하고, Advisor는 추천과 근거만 줍니다. 신원처럼 민감한 라우팅은 Copilot에 두는 식으로 팀이 위임을 정합니다.
CodeBridge Mini Lab: 운영 로그에서 실패 경로 모으기
도입 검토라면 로그부터 모으세요.
1. 실패 수집: 운영 로그에서 끝내지 못한 작업과 규칙 위반, 안전 문제를 따로
2. 경로 추적: 최종 답이 아니라 핸드오프와 도구, 상태가 어디서 어긋났는지
3. 목표 대조: 7개 중 어느 목표를 놓쳤는지, 하나만 올리면 어디가 깨지는지
4. 수정 전후: 작업 완료율과 회귀 실패를 자동 평가로 비교
5. 위임 정하기: 자동 유지와 사람 승인, 추천만 받기를 어디에 둘지
Kore.ai가 직접 밝힌 경계도 기억하세요. 목표에 없는 건 최적화 대상이 안 되고, 약한 테스트는 돌린다고 강한 근거가 안 됩니다. 도구와 데이터가 없거나 정책 결정이 필요한 막힘은 사람이 풀어야 합니다. 점수 올리려고 아무 변경이나 시도하지 않는다는 겁니다.
평가·안전 체크리스트 글의 도입 전 측정과 실전 패턴 글의 붙일 위치 얘기와 함께 보면 좋습니다.
결론: 평가는 행사가 아니라 루프다
한 줄로 정리합니다.
에이전트는 한 번 고쳐서 좋아지는 게 아니라, 목표와 흔적, 검증이 돌 때 좋아진다.
Autoloop이 보여주는 건 자동 마법이 아니라 검증된 유지입니다. 목표를 정하고, 경로를 보고, 부품을 고치고, 7개로 다시 재는 겁니다. 운영 로그에서 실패 경로를 모아 수정 전후의 완료율과 회귀를 자동으로 재보세요. 그 루프가 도는 팀이 에이전트를 오래 운영합니다.
함께 읽으면 좋은 글
참고 자료
- Kore.ai: Introducing Autoloop, continuous agent optimization at production scale (2026-10-07)
- Kore.ai: AI-native Agent Platform
- Kore.ai Docs: Optimize with Arch
- Kore.ai Docs: Evaluations
- SiliconAngle: Kore.ai launches Autoloop to keep tuning enterprise agents after they go live (2026-10-07)
- Constellation Research: Autoloop available (2026-10-07)
- DevCuration: Kore.ai Autoloop targets verified repair (2026-10-10)
이 주제를 직접 따라가며 배우고 싶다면
실행과 검증이 반복되는 에이전트 루프를 직접 만들고, 실패를 추적해 고치는 연습이 필요하다면 하네스와 루프, 그래프를 쌓는 과정이 이 글의 진단과 재검증 이야기와 바로 이어집니다.