
10월 6일, OpenAI가 조금 낯선 API를 공개 베타로 내놨습니다. 이름은 Decisions API. GPT처럼 글을 쓰는 게 아니라, 참일 확률과 정해진 선택지, 순서 있는 점수를 내놓는 API입니다. 밑에 깔리는 모델은 GPT-6 Luna 하나입니다.
발표 문장에서 가장 먼저 눈에 들어오는 건 역시 속도입니다. Responses API로 같은 모델을 부르는 것보다 약 10배 빠르다는 설명입니다. 다만 이 수치는 공급사가 내놓은 것이고, 독립적으로 다시 잰 결과는 아직 없습니다. 이 글에서는 숫자보다 먼저 이 API가 뭘 하는 물건인지부터 차분히 정리해봅니다.
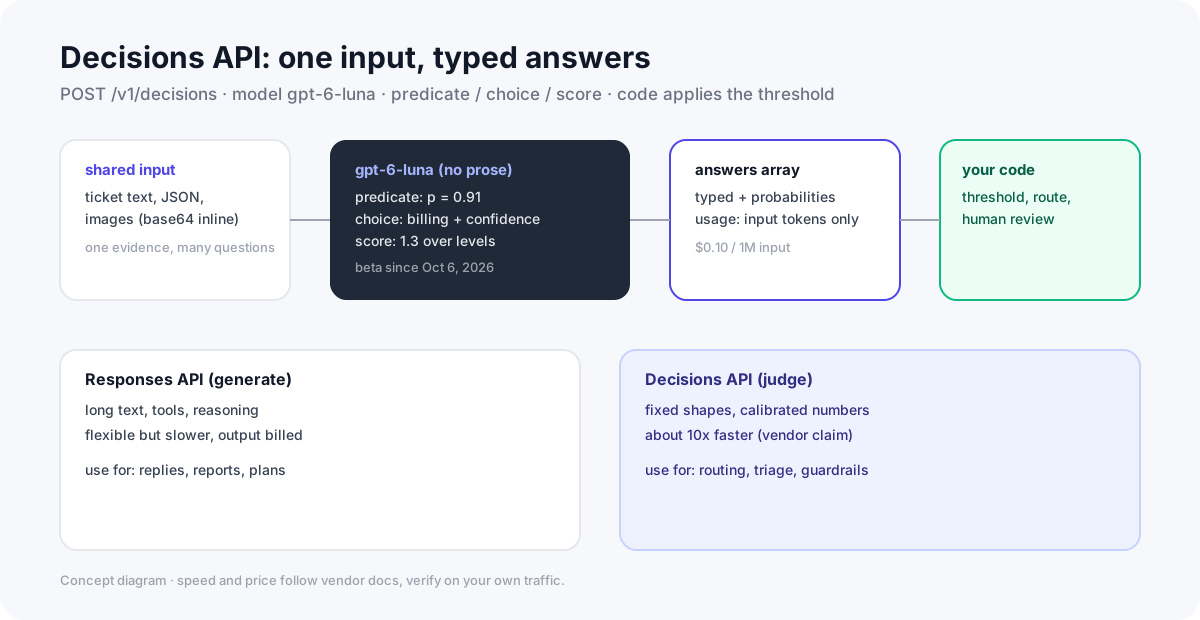
위 그림이 전체입니다. 입력은 하나, 질문은 여러 개, 답은 정해진 모양. 그리고 마지막 판단은 코드가 합니다.
한 줄 요약: 글을 쓰지 않고 고르기만 한다
공식 안내의 표현을 빌리면 이렇습니다.
같은 입력에 대해 참 확률과 선택, 점수를 묻고 확률로 답한다.
조금 풀어보죠. 고객 문의 하나가 들어오면 보통 두 가지 일이 필요합니다. 무슨 뜻인지 판단하는 일과, 사람에게 보여줄 문장을 쓰는 일입니다. Decisions API는 앞쪽만 맡습니다.
Responses API:  상황 -> 긴 글, 도구 호출, 추론 (유연하지만 느림)
Decisions API:  상황 + 질문들 -> 확률 JSON (빠르고 모양 고정)
이 자리는 낯설지 않습니다. Jev 글에서 본 System One 모델과 같은 자리이고, Microsoft Decision 글에서 본 Choice와 Yes/No, Score와 같은 모양입니다. 다른 점은 OpenAI API라는 친숙한 통로로 들어왔다는 것입니다.
질문 세 가지 모양: predicate, choice, score
요청은 단순합니다. 모델과 입력, 그리고 질문 배열을 POST /v1/decisions로 보냅니다. 질문은 세 종류입니다.
| 종류 | 묻는 것 | 돌아오는 것 | 쓸 때 |
|---|---|---|---|
| predicate | 이 문장이 참인가 | 0부터 1까지 확률 | 코드가 if로 가지를 탈 때 |
| choice | 정해진 값 중 어느 것인가 | 선택값과 선택지별 확률, confidence | 담당팀이나 경로가 갈릴 때 |
| score | 순서 있는 기준에서 어디인가 | 레벨 사이 값과 레벨별 확률, confidence | 긴급도나 심각도를 잴 때 |
여러 질문을 한 요청에 묶을 수 있다는 점이 실무에서 편합니다. 환불 요청인지와 담당팀, 긴급도를 한 번에 물을 수 있습니다. 질문끼리 답에 의존하면 요청을 나눠야 한다는 점은 공식 가이드에 적혀 있습니다. 한 요청 안의 질문들은 같은 입력을 두고 따로 답하기 때문입니다.
이미지는 base64 인라인만 되고, 호스팅 URL이나 파일 ID는 안 됩니다. 한 번의 판단에 스크린샷을 같이 넣는 용도라고 보면 됩니다. 버튼 고르기나 폼 이동, 위험한 도구 호출 걸러내기가 공식 예시로 거론됩니다.
진짜 호출 예시로 감을 잡아보죠. 이중 결제 환불 문의 하나입니다.
curl https://api.openai.com/v1/decisions \
  -H "Authorization: Bearer $OPENAI_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "gpt-6-luna",
    "input": "The package arrived today. The screen is cracked and it will not turn on.",
    "questions": [
      {
        "type": "predicate",
        "name": "damaged",
        "instructions": "Does the customer report that the delivered item is damaged?"
      },
      {
        "type": "choice",
        "name": "route",
        "instructions": "Choose the best support route.",
        "choices": [
          {"value": "damage_claim", "description": "A delivered product is physically damaged."},
          {"value": "technical_support", "description": "The product is intact but has a technical problem."},
          {"value": "general_support", "description": "Neither specialist route applies."}
        ]
      }
    ]
  }'
돌아오는 answers에는 질문 순서대로 답이 담깁니다. predicate는 probability 하나, choice는 choice와 confidence, 확률 분포가 함께 옵니다. 모델이 답을 거절하면 해당 위치에 refusal이 들어갑니다. 이름이 겹치면 안 되고, choice 값은 문자열과 불리언을 섞을 때 true와 "true"를 같이 두면 안 됩니다.
LangChain 쪽 연동도 같은 결입니다. OpenAIDecisions를 Runnable로 감싸서 input과 questions를 함께 invoke하고, predicates와 choices, scores로 나눠 읽습니다. 에이전트 미들웨어에서 특정 시점에 끼워 넣는 용도가 안내돼 있습니다.
가격과 속도: 입력만 내고 10배는 따로 재야 한다
가격 구조가 단순합니다. gpt-6-luna 기준으로 입력 100만 토큰당 $0.10, 출력과 캐시 읽기와 쓰기는 과금이 없습니다. 지역 처리와 긴 문맥에는 할증이 붙을 수 있습니다. 한마디로 보내는 분량이 곧 요금입니다.
속도 얘기는 조심해서 읽어야 합니다. 약 10배라는 수치는 OpenAI의 상품 설명이고, 네트워크와 입력 크기, 동시성, 지역에 따라 달라집니다. Vercel AI Gateway 쪽 측정에서는 같은 Decisions 모델의 지연이 0.29초로 적혀 있지만, 이것도 특정 환경의 수치입니다.
더 흥미로운 건 커뮤니티의 초기 실험입니다. 동전 편향 테스트에서 predicate는 기대 확률을 비교적 잘 따랐는데, choice는 가장 유력한 쪽에 확률을 너무 몰아줬다는 보고가 있습니다. 70대 30짜리 동전을 choice로 물으니 98대 2처럼 나왔다는 겁니다. 아직 베타 초기라 단정할 수는 없지만, 확신도 숫자를 그대로 믿기 전에 내 데이터에서 보정부터 확인하라는 신호로는 충분합니다.
confidence도 마찬가지입니다. 공식 가이드에 계산식이 공개돼 있지 않습니다. 0.8 같은 예쁜 숫자로 임계값을 고정하지 말고, 라벨 있는 내 트래픽에서 거짓 긍정의 비용과 거짓 부정의 비용을 저울질해서 정하라는 게 가이드의 조언입니다.
CodeBridge Mini Lab: Jev·Laya·Decision-1과 같은 시험지로
이 API를 써보기 전에 시험지부터 만드세요. 브리핑에서 말한 실무 액션 그대로입니다.
1. 100개 모으기: 실제 입력과 정답 라벨, 애매한 것도 버리지 말기
2. 고정하기: 모델 ID 기록, 입력 바이트 동일, 같은 질문 문구
3. 같이 재기: 정확도와 보정, p50과 p95, 정답당 비용
4. 나눠 보기: predicate와 choice를 따로, 작업별로 쪼개서
5. 게이팅 확인: 0.9 이상은 자동, 그 아래는 사람 검토로 두고 정확도 보기
비교 상대는 이미 정리돼 있습니다. 공정 비교 글에서 다뤘듯 Microsoft 수치와 JevBench, Laya 수치는 각자 다른 시험입니다. 같은 입력으로 붙인 sysone-bench 실험처럼 내 100개로 직접 붙여야 합니다. 어디에 붙이면 돈이 되는지는 실전 패턴 글에서, 도입 전 체크리스트는 평가·안전 글에서 이어집니다.
결론: 판단은 API의 기능이 아니라 계층이 되고 있다
한 줄로 정리합니다.
답을 쓰는 일과 고르는 일을 나누고, 고르는 쪽에는 확률과 임계값을 붙여라.
Decisions API가 보여주는 건 거창한 교체가 아니라 분업입니다. 단순 분류와 라우팅, 가드레일은 빠르고 싼 판단 쪽에, 열린 생성과 도구 사용은 Responses 쪽에 두는 겁니다. 베타이니 동작과 요금은 바뀔 수 있습니다. 지금 할 일은 내 서비스에서 고르는 단계 하나를 떼어내 100개짜리 시험지를 만드는 것입니다.
함께 읽으면 좋은 글
- Jev란? 문장을 쓰지 않고 결정을 내리는 AI
- 판단만 하는 AI가 나왔다: Microsoft-Decision-1 개요
- Jev·Laya·Microsoft를 한 줄로 세우면 틀린다: 공정한 비교법
참고 자료
- OpenAI Developer Community: Decisions API is now available in Public Beta (2026-10-06)
- OpenAI Developers: GPT-6 Luna model page
- Vercel: What is OpenAI Decisions API
- Vercel Changelog: OpenAI Decisions API now available on AI Gateway (2026-10-07)
- OpenRouter: GPT-6 Luna Decisions pricing and providers
- StackOne: What is OpenAI Decisions API, and when to use it (2026-10-07)
- Rubic8: OpenAI Decisions API typed answers guide (2026-10-07)
- ImportStatic: OpenAI Decisions API in Go (2026-10-08)
- LangChain Docs: OpenAI Decisions integration
이 주제를 직접 따라가며 배우고 싶다면
판단 API를 써보는 것과 운영에 붙이는 것은 다른 일입니다. 상태와 질문을 어떻게 만들고, 확신도 몇에서 자동 처리와 사람 검토를 나눌지 정하는 부분이 실무에서 가장 막막합니다.
실무 Decision AI 과정에서는 판단 모델을 직접 실행하면서 상태 설계부터 Choice와 Score 해석, 확신도와 정책·Human Review 연결까지 한 흐름으로 연습합니다. 반복되는 판단 하나를 떼어내고 싶은 분이라면, 이 글의 Mini Lab 다음 순서로 이어서 보셔도 좋습니다.