
k-means는 기계학습에서 거의 유일하게 풀배치 최적화가 여전히 널리 쓰이는 문제다. 1957년 Bell Labs 기술 노트로 돌아가는 Lloyd 알고리즘은 매 iteration마다 전체 데이터를 훑어 모든 점을 가장 가까운 중심에 배정하고, 중심을 다시 계산한다. 데이터가 10억 개가 되면 이 “전체를 다시 센다”는 비용이 알고리즘의 성질을 결정한다.
Meta FAIR의 e-means 논문은 이 전제를 바꾼다. 미니배치마다 클러스터의 합과 개수를 지수이동평균(exponential moving average)으로 갱신하고, 배치 크기와 학습률을 문제 크기에서 계산해 넣는다. 논문은 Lloyd가 25 epoch에 도달한 손실을 1.4~2.6 epoch에 따라잡는다고 보고한다. 프로젝트 사이트는 범위를 1.2~3 epoch로 적는다. 이 글은 논문과 공개 코드를 읽은 리뷰다. CodeBridge가 직접 클러스터링 실험을 재현하지는 않았다.
문제는 “더 나은 중심”이 아니라 “더 적은 패스”다
k-means의 목표는 고정된 데이터셋 X에서 k개의 중심 C를 골라 평균 제곱거리를 최소화하는 것이다. Lloyd는 각 점을 가장 가까운 중심에 배정하고, 배정된 점들의 정확한 평균으로 중심을 바꾼다. 손실은 단조 감소하지만, 한 번의 업데이트에 데이터 전체를 한 번씩 읽어야 한다. 보통 20~50 iteration을 돈다.
미니배치 k-means는 오래전부터 있었다. 그러나 대부분 1967년 MacQueen 업데이트를 따른다. MacQueen은 배치의 합과 개수를 버리지 않고 계속 누적한다. 중심은 “학습 시작 이후 이 클러스터에 배정된 모든 점”의 균등 평균이 된다. 초기 중심이 나빴을 때의 배정까지 현재 중심에 영향을 준다. 데이터가 많을수록 오래된 정보가 무거워진다.
e-means의 출발점은 이 차이를 인정하는 것이다. 정적 데이터셋에서도 최근 배정을 더 신뢰하는 편이 빠르게 수렴한다. VQ-VAE처럼 분포가 움직이는 환경에서 쓰던 이동평균을, 정적 k-means에 맞게 다시 조율하면 된다는 관찰이다.
업데이트 규칙: 합과 개수를 잊는다
각 클러스터 j에 대해 합 S_j와 개수 N_j를 유지하고, 중심은 c_j = S_j / N_j로 둔다. 세 알고리즘의 차이는 S_j와 N_j를 어떻게 갱신하느냐뿐이다. 현재 배치에서 클러스터 j에 배정된 점들의 합을 s_j, 개수를 n_j라고 하자.
Lloyd      S_j ← s_j                    N_j ← n_j
MacQueen   S_j ← S_j + s_j              N_j ← N_j + n_j
e-means    S_j ← (1−α)S_j + α·s_j       N_j ← (1−α)N_j + α·n_j
e-means에서 α는 망각률이다. 오래된 배정은 α 비율로 잊히고, 중심은 전체 역사가 아니라 최근 배정을 따라간다. α = 1이고 배치가 전체 데이터라면 e-means는 정확히 Lloyd가 된다. 즉 Lloyd는 e-means의 특수한 경우다. 이 관점은 “새 알고리즘이 옛 알고리즘을 대체한다”기보다 “옛 알고리즘이 하이퍼파라미터 하나를 극단으로 둔 경우”임을 보여준다.
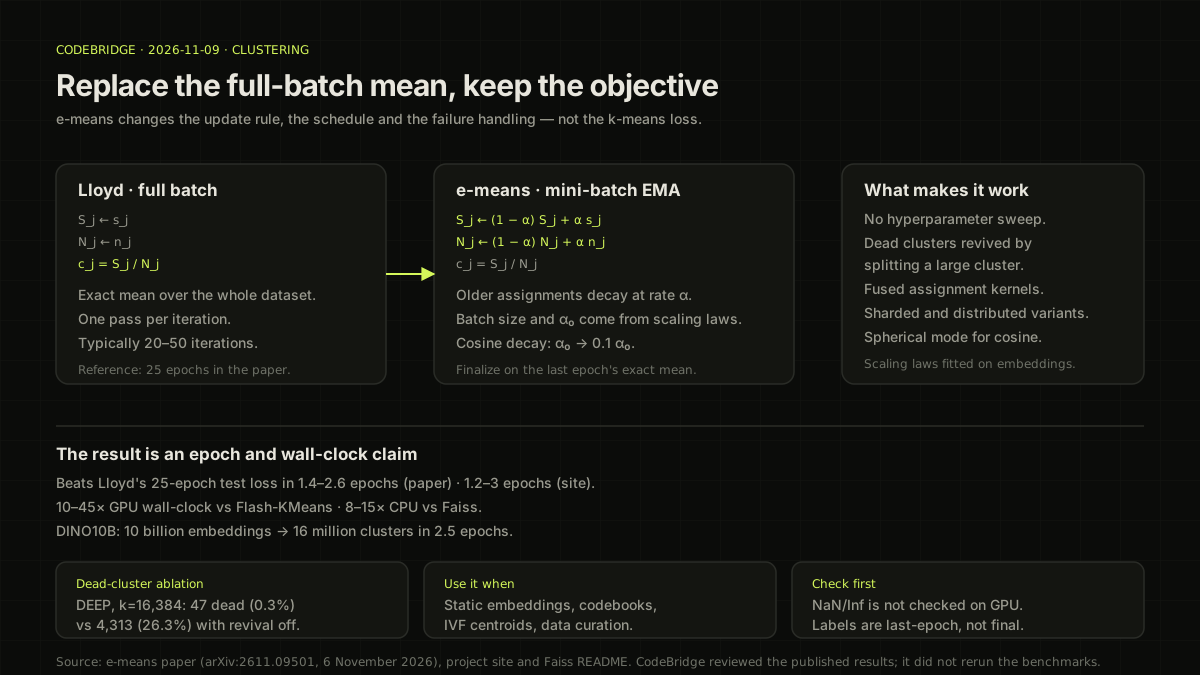
단순히 α를 작게 잡는다고 빨라지지는 않는다. 배치가 작으면 gradient noise가 커져 진동하고, 배치가 크면 한 epoch의 업데이트 횟수가 줄어든다. e-means가 실제로 작동하는 이유는 나머지 세 부품에 있다.
부품 1: 스케일링 법칙이 배치와 학습률을 정한다
e-means는 사용자가 배치 크기 B와 초기 학습률 α₀를 고르지 않아도 된다고 주장한다. 대신 문제의 특성 (n, k, T)에서 두 값을 계산하는 스케일링 법칙을 fit했다. n은 점 개수, k는 클러스터 수, T는 epoch 수다.
B    = c_B · k^{b_k} · n^{b_n} · T^{b_T}
α₀   = min(c_α · k^{a_k} · B^{a_B} · n^{a_n} · T^{a_T}, 1)
논문은 두 가지 배치 법칙을 제안한다. 기본(default) 법칙은 처리량을 우선하고, 품질(quality) 법칙은 같은 계산량에서 더 낮은 손실을 노린다. 프로젝트 사이트의 표에 따르면 학습률 법칙의 R²는 0.95, 기본 배치 법칙은 0.96이다. held-out 데이터셋과 held-out 크기에서의 regret도 0.07~0.2% 수준으로 보고된다. “하이퍼파라미터 탐색 없이”라는 말은 이 fit에 기대고 있다.
여기에 cosine scheduling이 붙는다. α는 α₀에서 시작해 학습이 끝날 때 0.1α₀까지 줄어든다. 마지막에는 각 클러스터의 마지막 epoch 정확한 평균으로 끝내는 finalization 단계가 있다. 런타임 비용은 거의 없지만 손실을 조금 더 낮춘다.
부품 2: 죽은 클러스터를 큰 클러스터를 쪼개서 살린다
미니배치 k-means의 고질적인 문제는 죽은 클러스터다. 어떤 중심에 점이 하나도 배정되지 않으면 코드북의 유효 크기가 줄어든다. 클러스터 수가 16,384처럼 커지면 이 손실이 커진다.
일반적인 처방은 배치에서 무작위 점을 뽑아 죽은 중심을 대체하는 것이다. EnCodec 방식이다. e-means는 대신 큰 활성 클러스터를 크기에 비례해 뽑아 두 개로 쪼갠다. Faiss k-means에서 가져온 전략이다.
효과는 ablation에 나온다. 100만 벡터, k=16,384, 5 epoch, 5 seed 평균에서 DEEP 데이터셋의 죽은 클러스터는 다음과 같다.
| 복구 정책 | 죽은 클러스터 | 코드북 비율 | 불균형 | test MSE |
|---|---|---|---|---|
| 비례 분할 (e-means) | 47 | 0.3% | 1.194 | 0.38762 |
| 배치에서 재샘플 (EnCodec) | 2,343 | 14.3% | 1.423 | 0.39124 |
| 끔 | 4,313 | 26.3% | 1.647 | 0.39448 |
SIFT에서도 비례 분할은 10개(0.1%), 재샘플은 750개(4.6%), 끔은 2,080개(12.7%)다. 죽은 클러스터를 줄이는 것과 손실을 낮추는 것이 같은 방향임을 보여준다.
부품 3: 미니배치가 지역 최솟값을 더 잘 빠져나온다
논문의 흥미로운 관찰은 e-means가 단순히 빠른 것이 아니라 더 낮은 손실에 도달한다는 점이다. 저자들은 200개 seed로 장난감 데이터셋을 반복 학습해 지역 최솟값에 갇히는 비율을 셌다.
- 크기가 다른 두 덩어리, k=8: Lloyd는 26%의 시작에서 갇히고 e-means는 3.5%다.
- 3×3 격자의 아홉 덩어리, k=10: Lloyd는 43%의 시작에서 1% 이상 나쁘고 e-means는 4%다.
- 한 줄에 놓인 다섯 덩어리, k=5: Lloyd는 46%의 시작에서 갇히고 e-means는 0%다.
저자들의 설명은 “Lloyd의 손실은 항상 감소하므로, 일단 지역 최솟값에 들어가면 나올 이유가 없다”는 것이다. 미니배치는 업데이트에 잡음이 있어 더 넓게 탐색하고, 나쁜 배치에서 빠져나올 기회를 만든다. 속도와 품질이 보통 trade-off 관계인 k-means에서 둘 다 얻는다는 주장의 근거다.
증거: 24개 데이터셋과 DINO10B
논문은 24개의 임베딩·합성 데이터셋과 구성에서 검증했다고 밝힌다. 프로젝트 사이트는 16개 데이터셋, 10만~1억 개 점, 234개 구성을 비교한 결과 지도를 공개한다. 대표적인 수치는 다음과 같다.
- VIBE 임베딩 벤치마크 11개에서 Lloyd의 25 epoch test error에 도달하는 데 1.6~2.4 epoch가 걸렸다. 텍스트·코드·이미지·멀티모달 임베딩, 차원 200~3,072, k=8,192 또는 16,384다.
- 1,000만 벡터, k=65,536, H100 한 장에서 25 epoch PyTorch Lloyd는 142~155초, Flash-KMeans는 14~22초, e-means는 그보다 더 짧다.
- DINO10B의 100억 개 DINO 임베딩을 1,600만 클러스터로 나누는 데 2.5 epoch가 걸렸고, 손실은 Lloyd의 25 epoch보다 낮았다.
이 숫자들은 저자들이 공개한 것이다. CodeBridge는 Faiss 구현을 설치해 같은 데이터셋에서 재현하지 않았다. “10~45배”는 GPU wall-clock 기준이고, “8~15배”는 CPU에서 Faiss Lloyd와 비교한 값이다. 베이스라인과 하드웨어를 함께 읽어야 한다.
적용: 어디에 먼저 쓸까
e-means가 가장 잘 맞는 곳은 임베딩을 대규모로 클러스터링하는 파이프라인이다. 검색 인덱스의 coarse quantizer, 데이터 큐레이션의 중복 제거, 추천 후보의 군집화, RAG 문서 집합의 주제 분할 같은 작업이다. 데이터가 고정되어 있고, 클러스터 수가 크며, 한 번 돌리는 비용이 큰 경우에 epoch 감소가 그대로 비용 감소로 이어진다.
코드 인터페이스는 단순하다.
from faiss.contrib.e_means import Emeans

em = Emeans(d, k, nepochs=T)          # 기본 T=5
centroids, labels = em.train(x)       # x: PyTorch tensor (n, d)
NumPy를 쓴다면 NumpyEmeans를 쓴다. 기존 Lloyd 파이프라인을 완전히 버릴 필요는 없다. 먼저 같은 데이터에서 e-means의 손실과 Lloyd의 손실을 비교하고, 클러스터 크기 분포와 다운스트림 지표가 유지되는지 확인하는 방식이 현실적이다.
한계: 정적 데이터셋, 그리고 “평균”의 함정
첫째, e-means는 정적 데이터셋을 전제로 한다. 논문도 VQ-VAE의 코드북 학습처럼 분포가 계속 움직이는 문제와 구분한다. 이동평균은 원래 그런 환경에서 쓰였지만, e-means의 스케일링 법칙과 finalization은 고정된 X를 가정해 fit되었다. 온라인 학습에 그대로 적용하려면 별도 검증이 필요하다.
둘째, 손실이 낮다고 다운스트림 품질이 항상 좋아지는 것은 아니다. 검색이나 분류에서 클러스터의 균형, 해석 가능성, 특정 클래스와의 정렬이 더 중요할 수 있다. 논문의 지표는 test MSE와 클러스터 크기 불균형이다. 내 태스크의 지표로 다시 재야 한다.
셋째, “하이퍼파라미터가 없다”는 말은 스케일링 법칙의 적용 범위 안에서 참이다. 논문이 fit한 n, k, T 범위를 크게 벗어나면 법칙의 예측력이 떨어진다. 또한 GPU 커널과 CPU 구현의 이득이 다르므로, 배포 환경에서 실제 wall-clock을 재야 한다.
인사이트: 오래된 알고리즘을 최신 최적화로 다시 읽기
e-means의 진짜 메시지는 “k-means가 느리다”가 아니다. k-means가 유일하게 풀배치 최적화를 고집하는 문제였고, 그 이유가 정확도가 아니라 관성이었을 수 있다는 것이다. 이동평균, 스케일링 법칙, cosine scheduling, 죽은 클러스터 복구, fused kernel은 모두 딥러닝에서 이미 쓰던 도구다. 이를 1957년의 문제에 다시 조립하니 epoch가 10분의 1로 줄었다.
도입을 검토한다면 질문은 “e-means가 k-means보다 빠른가”가 아니라 “내 데이터가 정적인가, 클러스터 수가 충분히 큰가, 손실 외에 어떤 지표를 지켜야 하는가”다. 세 질문에 답한 뒤 같은 데이터에서 두 알고리즘을 나란히 돌려보는 것이 첫 단계다. 논문의 1.4~2.6 epoch는 그 실험의 가설이지, 내 파이프라인의 보장이 아니다.
임베딩 검색 파이프라인의 구조를 더 알고 싶다면 RAG 시스템 강의에서 검색·생성 아키텍처를 이어서 볼 수 있다. 모델 라우팅 비용은 Muse Ember, 로컬 모델의 메모리 경계는 Nota AI의 1.58비트에서 다룬다.