
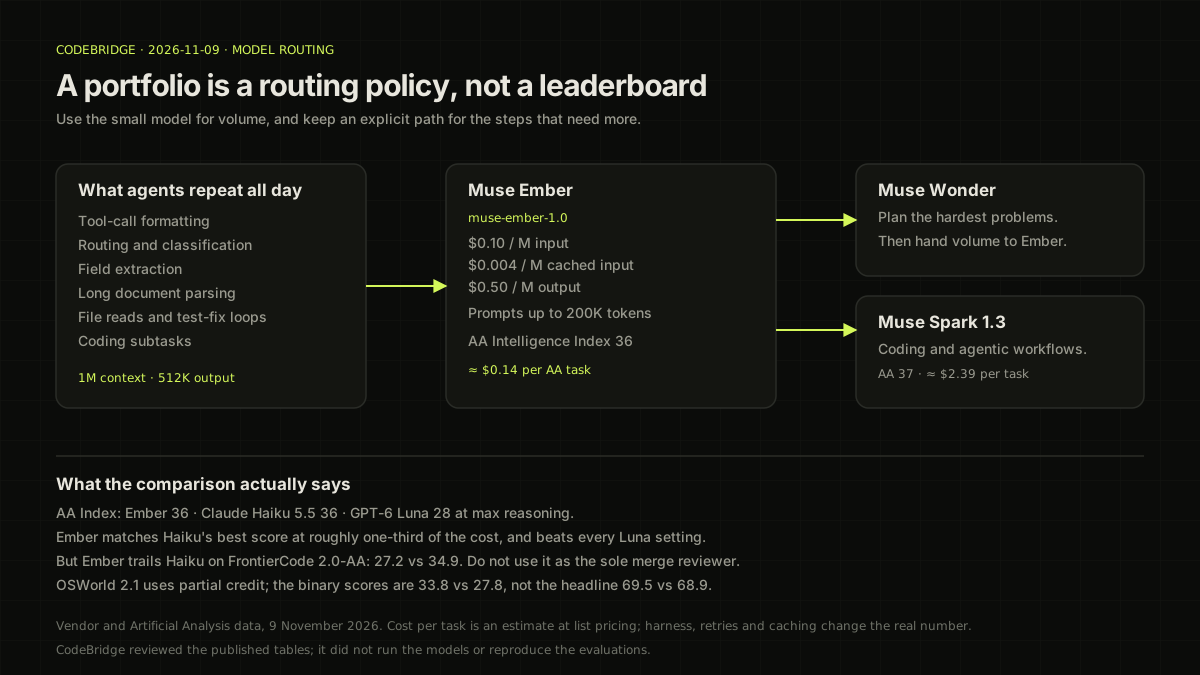
Meta가 Muse Ember를 소개할 때 가장 먼저 내세운 문장은 “가장 작고 효율적인 모델”입니다. 하지만 실무에서 더 중요한 문장은 그다음에 나옵니다. “에이전트가 하루 종일 반복하는 작업—도구 호출, 코딩 하위 작업, 라우팅, 추출, 긴 문서 파싱—을 위해 설계됐다”는 것입니다. Muse Ember는 어려운 문제를 혼자 해결하는 모델이 아니라, 반복되는 작은 단계를 싸게 처리하고 어려운 단계만 상위 모델로 넘기는 포트폴리오의 한 칸입니다.
공식 발표는 2026년 11월 9일자입니다. 1M 토큰 컨텍스트, 최대 512K 출력, muse-ember-1.0 모델 ID, Muse Code와 Meta Model API 제공, Google Cloud와 Oracle Cloud 지원이 함께 발표됐습니다. 이 글은 공개된 가격표와 평가표를 읽은 분석이며, 모델을 직접 호출하거나 벤치마크를 재현하지 않았습니다.
작은 모델을 위한 가격 구조
Muse Ember의 가격은 200K 토큰 이하 프롬프트 기준으로 입력 $0.10/M, 캐시 입력 $0.004/M, 출력 $0.50/M입니다. 200K를 넘으면 입력 $0.30/M, 캐시 입력 $0.012/M, 출력 $1.50/M로 올라갑니다. 1M 컨텍스트를 지원한다는 사실과 1M 컨텍스트를 싸게 쓴다는 사실은 다릅니다. 긴 문서를 통째로 넣는 라우팅을 설계한다면 이 가격 절벽을 먼저 계산해야 합니다.
Meta는 Artificial Analysis 기준 작업당 비용을 약 $0.14로 표시합니다. 같은 표에서 Muse Spark 1.3은 $2.39입니다. 17배 차이입니다. “가장 똑똑한 모델”을 모든 단계에 쓰는 대신, 반복 단계는 Ember로 내리고 계획·난이도 높은 디버깅·병합 판단은 상위 모델로 올리는 구조가 비용상 합리적입니다.
평가표를 읽는 법
Meta가 공개한 표는 모델별 최고 설정을 비교합니다. 핵심 숫자는 다음과 같습니다.
| 평가 | Muse Ember (max) | Claude Haiku 5.5 (max) | GPT-6 Luna (max) |
|---|---|---|---|
| AutomationBench-AA | 37.8 | 13.9 | 20.2 |
| Agents' Last Exam | 61.6 | 57.0 | 57.1 |
| Personal Superintelligence Index | 46.8 | 36.1 | 37.0 |
| Terminal-Bench 4.0 | 40.9 | 39.2 | 16.4 |
| Coding Agent Index-AA | 46 | 37 | 31 |
| FrontierCode 2.0-AA | 27.2 | 34.9 | 25.2 |
| GDP.pdf-AA | 22.8 | 20.8 | 22.8 |
| OSWorld 2.1 (partial) | 69.5 | 68.9 | 50.5 |
| PerceptionBench (tools) | 80.6 | 78.6 | 62.8 |
| Artificial Analysis Index | 36 | 36 | 28 |
Muse Ember는 AutomationBench-AA, Agents' Last Exam, Coding Agent Index-AA, PerceptionBench에서 앞섭니다. 반면 FrontierCode 2.0-AA에서는 27.2로 Haiku 5.5의 34.9에 뒤집니다. FrontierCode는 “실제 엔지니어링 작업을 병합 가능성 기준으로 판정”하는 평가입니다. Ember가 코딩 하위 작업에 강하다는 것과, 최종 코드 변경의 병합 가능성을 판단하는 데 최적이라는 것은 다른 주장입니다.
OSWorld 2.1도 주의해서 읽어야 합니다. 표의 69.5는 partial-credit 점수이고, 괄호 안 binary 점수는 33.8입니다. Haiku는 68.9/27.8, Luna는 50.5/17.0입니다. partial과 binary를 섞어 “거의 같다”고 말하면 안 됩니다. 평가 방식이 다르면 숫자의 의미도 달라집니다.
라우팅 정책을 어떻게 짤 것인가
가장 실용적인 출발점은 작업을 “실패 비용”과 “반복 횟수”로 나누는 것입니다. 도구 호출 형식 맞추기, 검색 결과 분류, 문서에서 필드 추출, 파일 읽기, 테스트 실패 로그 요약은 실패해도 재시도 비용이 작고 호출 횟수가 많습니다. Ember에 적합합니다. 반면 아키텍처 결정, 원인을 모르는 버그의 가설 수립, 보안에 민감한 코드 리뷰, 최종 병합 판단은 실패 비용이 큽니다. 이 단계는 Wonder나 Spark로 올리고, Ember의 출력은 후보 생성으로 제한하는 편이 안전합니다.
task → classify
  ├─ repeated, low failure cost → Ember
  │    tool format · extraction · routing · file reads
  ├─ plan or ambiguous debugging → Wonder
  └─ coding / agentic workflow → Spark
       └─ final merge judgment → human + stronger model
이 도식은 Meta의 공식 아키텍처가 아니라 이 글의 제안입니다. Meta는 “Muse Wonder가 계획하고 Muse Ember가 볼륨을 처리한다”고 표현하지만, 구체적인 라우팅 규칙은 제품마다 다릅니다. 중요한 것은 “작은 모델 하나로 모든 단계를 처리”하지도, “가장 큰 모델 하나로 모든 단계를 처리”하지도 않는 것입니다.
비용/성공 작업으로 측정하기
모델 가격표만 보고 라우팅을 결정하면 절반만 보는 것입니다. 실제 비용은 토큰 단가 × 토큰 수 × 재시도 횟수 × 에스컬레이션 비율입니다. Ember가 10번 중 8번 성공하고 2번을 상위 모델로 올린다면, 평균 비용은 Ember 호출 10번 + 상위 모델 2번입니다. Ember가 10번 중 5번 실패해 5번을 올린다면, 절반의 작업에 두 배의 호출이 붙습니다.
따라서 라우팅 실험의 단위는 “토큰당 비용”이 아니라 “성공한 작업당 비용”이어야 합니다. 작업 정의, 성공 판정, 재시도 상한, 캐시 적중률, 에스컬레이션 규칙을 함께 기록해야 비교가 됩니다. Meta의 $0.14도 Artificial Analysis 작업 정의와 리스트 가격을 전제로 한 추정치입니다. 내 워크플로의 $0.14가 아닙니다.
안전성과 한계
Meta는 Muse Ember를 Meta Superintelligence Scaling Framework 아래에서 화학·생물, 사이버보안, 통제 상실 위험으로 평가했고, 평가한 범주에서 고위험 임계값 아래에 머물렀다고 밝혔습니다. 또한 웹 페이지·문서·도구 출력에 숨은 지시를 얼마나 잘 따르지 않는지, 고영향 행동 전에 사람의 입력을 요청하는지도 평가했다고 합니다. 이는 벤더가 수행한 평가이며, 독립 검증 결과가 아닙니다.
기술적 한계도 분명합니다. 첫째, 1M 컨텍스트는 긴 문서를 한 번에 넣을 수 있게 하지만, 200K를 넘는 순간 단가가 오르고 지연 시간과 KV 캐시 비용도 커집니다. 둘째, Artificial Analysis Index 36은 종합 지표입니다. 내 작업이 코드 병합 가능성이라면 FrontierCode 2.0-AA의 27.2가 더 직접적입니다. 셋째, “more intelligence per dollar”는 Meta의 표현입니다. 작업 정의와 하네스가 바뀌면 비용 순위도 바뀝니다.
인사이트: 모델 선택에서 라우팅 설계로
Muse Ember의 진짜 의미는 “작은 모델이 큰 모델을 이겼다”가 아닙니다. 같은 Artificial Analysis Index 36을 약 1/3 비용으로 달성했다는 점, 그리고 그 모델을 반복 작업용으로 명확히 포지셔닝했다는 점입니다. 모델 포트폴리오가 커질수록 경쟁력은 단일 모델의 점수가 아니라 “어떤 작업을 어디로 보내고, 언제 올리고, 실패를 어떻게 측정하는가”에서 나옵니다.
다음에 작은 모델을 도입할 때는 리더보드 1등을 찾지 말고, 내 작업을 반복·저위험과 계획·고위험으로 나눈 뒤, 각 단계의 성공률과 에스컬레이션 비용을 측정하세요. Ember는 그 실험을 시작하기 좋은 기준점이지만, 최종 병합 판단까지 맡길 모델은 아닙니다.
로컬에서 30B 모델을 10GB로 줄이는 다른 비용 절감 경로는 Nota AI의 1.58비트에서, 에이전트 인프라의 시스템 비용은 TPU 8tx와 8i Max에서 이어서 볼 수 있습니다.