
구글의 발표 제목은 “새로운 TPU”라고 말하지만, 두 제품의 성격은 다릅니다. TPU 8tx는 TPU 8t와 같은 실리콘을 씁니다. TPU 8i Max는 TPU 8i 두 개를 한 패키지에 올렸습니다. 새로운 칩을 하나 더 만든 것이 아니라, 기존 칩 주변의 패키징·호스트 CPU·네트워크·보안·소프트웨어를 다시 조합해 새로운 “시스템”을 만든 것입니다.
2026년 11월 9일 구글 발표는 이 차이를 직접 설명합니다. 칩 설계는 수년이 걸리지만, 시스템은 컴퓨트·네트워킹·스토리지를 어떻게 묶는가의 문제이므로 몇 달 만에 새로운 구성이 나올 수 있다는 것입니다. 에이전트 시대의 인프라 경쟁이 칩 단품이 아니라 시스템 봉투(system envelope)로 옮겨가고 있다는 신호입니다.
4개 시스템, 하나의 포트폴리오
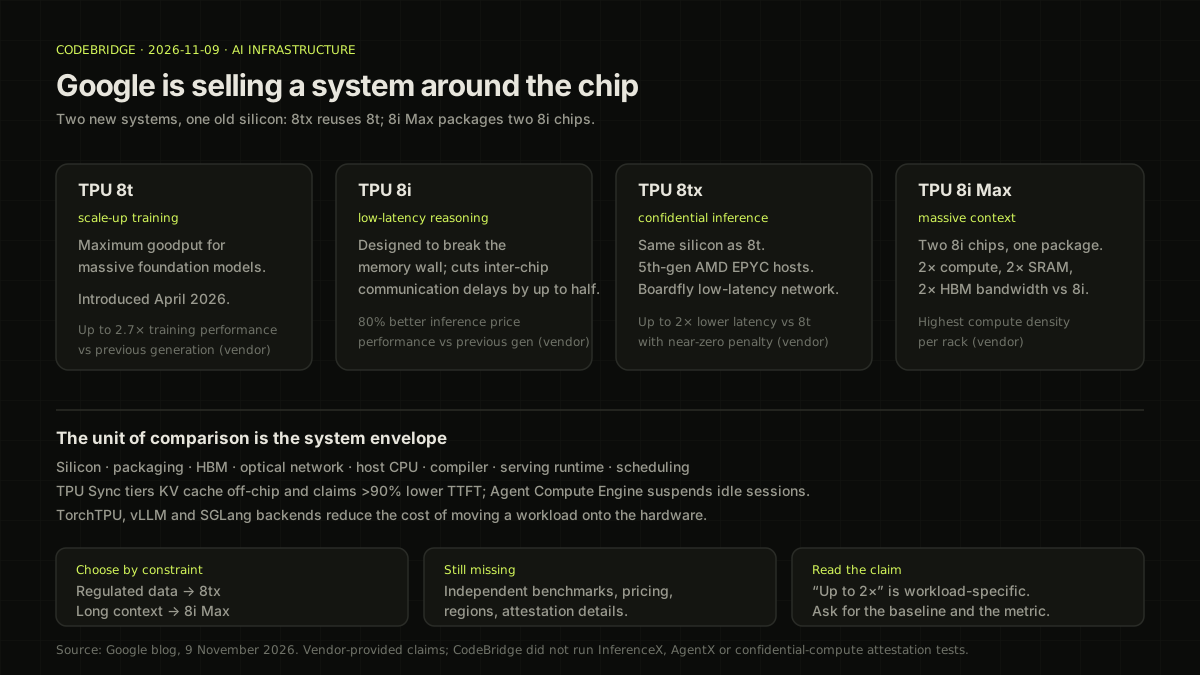
8세대 TPU 포트폴리오는 네 가지입니다. 8t는 대규모 사전학습, 8i는 실시간 추론, 8tx는 기밀 추론, 8i Max는 초대형 컨텍스트와 랙당 최고 컴퓨트 밀도를 겨냥합니다. 구글은 “한 해에 네 개의 TPU 시스템을 소개한 것은 처음”이라고 말합니다.
| 시스템 | 겨냥하는 단계 | 핵심 구성 | 공개된 주장 |
|---|---|---|---|
| TPU 8t | 대규모 학습 | 8세대 기본 학습 칩 | 이전 세대 대비 최대 2.7배 학습 성능 |
| TPU 8i | 저지연 추론 | 8세대 추론 칩 | 이전 세대 대비 80% 향상된 추론 가격 성능 |
| TPU 8tx | 기밀 추론·소규모 학습 | 8t와 같은 실리콘, 5세대 AMD EPYC 호스트, Boardfly | 8t 대비 최대 2배 낮은 지연, 거의 제로에 가까운 성능 저하 |
| TPU 8i Max | 초대형 컨텍스트·최고 밀도 | 8i 두 개를 한 패키지에 | 8i 대비 2배 컴퓨트·SRAM·HBM 대역폭 |
표의 수치는 모두 구글이 제공한 것입니다. CodeBridge는 InferenceX, AgentX, 기밀 컴퓨팅 attestation을 실행하지 않았습니다. “최대 2배”는 기준선과 워크로드가 무엇인지에 따라 달라지는 표현입니다.
8tx: 같은 칩, 다른 보안 계약
TPU 8tx의 핵심은 “새로운 칩”이 아니라 “같은 칩을 기밀 컴퓨팅 환경에 놓는 방법”입니다. 일반적으로 데이터는 저장 중이거나 네트워크로 전송될 때 암호화되지만, 프로세서가 처리하는 동안에는 메모리에서 복호화됩니다. 8tx는 하드웨어 계층에서 민감한 데이터와 모델 가중치를 사용 중에도 보호하고 격리한다고 합니다.
구성도 시스템적입니다. 8t와 같은 실리콘에 5세대 AMD EPYC CPU 호스트를 결합하고, 실시간 추론용으로 만든 저지연 Boardfly 네트워크를 붙입니다. 그 결과 8t 대비 최대 2배 낮은 지연을 제공하면서 “거의 제로에 가까운 성능 저하”를 주장합니다. 또한 학습급 컴퓨트와 빠른 추론 네트워크를 함께 쓰기 때문에, 민감한 데이터를 별도 클러스터로 옮기지 않고도 사설 데이터로 파인튜닝하고, 큰 모델을 작은 모델로 distill하고, 강화학습으로 에이전트를 학습할 수 있다고 합니다.
이 주장이 실제로 의미를 가지려면 세 가지를 확인해야 합니다. 첫째, 기밀 컴퓨팅의 위협 모델과 attestation 방식입니다. 둘째, 호스트 CPU와 가속기 사이의 데이터 경로가 어디까지 보호되는지입니다. 셋째, “거의 제로”가 어느 워크로드에서 측정된 것인지입니다. 보안은 기능 목록이 아니라 공격면과 키 관리의 문제입니다.
8i Max: 메모리 벽을 패키징으로 밀기
8i Max는 다른 문제를 풉니다. 여러 에이전트가 하나의 코드베이스나 몇 시간 분량의 비디오를 동시에 다루면 메모리 대역폭이 병목이 됩니다. 구글은 저지연 8i 칩 두 개를 한 패키지에 올려 컴퓨트와 메모리를 함께 확장했습니다. 8i 대비 2배의 컴퓨트, 2배의 SRAM, 2배의 HBM 대역폭을 제공해 프로세서가 필요한 데이터를 계속 갖고 있도록 한다는 설명입니다.
밀도도 주장의 일부입니다. 기존 랙 공간에 두 배의 실리콘을 넣을 수 있어, 데이터센터가 평방피트와 와트당 더 많은 컴퓨트를 배치할 수 있다는 것입니다. 이는 전력·냉각·랙 설계와 맞물리는 문제이므로, “2배”가 실제 운영 비용에서 어떻게 나타나는지는 별도 검증이 필요합니다.
8i Max의 진짜 경쟁력은 칩 한 개의 FLOPS가 아니라, 초대형 컨텍스트를 처리할 때 메모리 계층을 얼마나 효율적으로 쓰는가에 있습니다. 구글은 같은 발표에서 TPU Sync를 오픈소스로 공개했습니다. HBM, 호스트 DRAM, 공유 스토리지, 데이터센터 네트워크를 하나의 메모리 계층으로 묶고, 대규모 KV 캐시를 밀리초 단위로 칩 밖으로 tiering하며, disaggregated prefill/decode 노드 사이로 컨텍스트를 스트리밍하고, RL 가중치를 동기화해 KV 전송 지연과 TTFT를 90% 이상 줄인다고 합니다.
소프트웨어가 시스템의 절반이다
이 발표에서 놓치기 쉬운 부분은 소프트웨어입니다. 구글은 TorchTPU를 오픈소스로 공개해 PyTorch 코드와 Hugging Face 모델이 TPU에서 네이티브로 실행되도록 했고, vLLM과 SGLang 백엔드도 제공합니다. TPU agent suite는 Claude Code, Cursor, Google Antigravity 같은 코딩 도구에 붙어 TPU 온보딩과 병목 진단, 커널 autotune을 자연어로 수행한다고 합니다. XLA Serving Engine은 Python으로 학습한 모델을 C++ 저지연 런타임으로 서빙합니다.
에이전트 플릿 운영도 소프트웨어 계층입니다. Agent Compute Engine은 상태를 가진 에이전트가 데이터베이스 조회, 외부 도구, 사람 피드백을 기다리며 몇 초에서 몇 시간씩 멈추는 동안 유휴 세션을 자동으로 중단·재개해 인프라 비용을 줄입니다. Cloud Pathways는 GKE에서 여러 TPU 슬라이스를 하나의 로컬 머신처럼 다루게 하고, GKE 동적 슬라이싱은 OCS(광 회로 스위칭)로 토폴로지를 즉석에서 재구성해 작업 시작 시간을 최대 5배, 장애 복구를 최대 4.5배 단축한다고 합니다.
이 기능들은 칩 사양표에는 나오지 않지만, 실제 에이전트 운영 비용에는 더 직접적으로 영향을 줄 수 있습니다. 모델이 아무리 빨라도 유휴 세션이 GPU/TPU를 점유하고 있으면 비용은 줄지 않습니다. KV 캐시가 칩 밖으로 나가는 순간 TTFT가 튀면 사용자 경험도 나빠집니다. 인프라 선택은 이제 “어떤 칩이 가장 빠른가”가 아니라 “어떤 시스템이 내 워크로드의 병목을 가장 싸게 처리하는가”입니다.
무엇이 아직 비어 있나
발표에는 가격, 리전, 정확한 가용 날짜가 없습니다. “거의 100개 고객”은 구글의 표현이고, 고객 구성과 워크로드 비중은 공개되지 않았습니다. 8i Max의 전력·열 설계, 8tx의 attestation 세부 사항, Boardfly 네트워크의 실제 토폴로지도 더 확인해야 합니다.
또한 “최대 2배 낮은 지연”과 “거의 제로에 가까운 성능 저하”는 서로 다른 기준선에서 나온 숫자일 수 있습니다. 8t 대비인지, 8i 대비인지, 어떤 모델·배치·시퀀스 길이에서 측정했는지에 따라 결과가 달라집니다. 벤더 블로그의 숫자는 방향을 잡는 데 유용하지만, 도입 결정에는 내 워크로드의 파일럿이 필요합니다.
인사이트: 칩이 아니라 봉투를 비교하라
TPU 8tx와 8i Max의 교훈은 “구글이 칩을 더 잘 만든다”가 아닙니다. 같은 실리콘을 다른 패키징과 네트워크, 보안, 소프트웨어로 묶어 전혀 다른 제품을 만든다는 점입니다. 8tx는 규제 산업의 데이터 주권 문제를, 8i Max는 에이전트의 초대형 컨텍스트 문제를 겨냥합니다. 둘 다 칩 단품의 성능표만으로는 설명되지 않습니다.
인프라를 평가할 때는 실리콘, 패키징, HBM, 광 네트워크, 호스트 CPU, 컴파일러, 서빙 런타임, 스케줄링을 하나의 봉투로 봐야 합니다. 그 봉투 안에서 내 작업의 병목이 어디인지—보안, 컨텍스트 길이, 유휴 세션, KV 캐시 이동—먼저 정의해야 합니다. “TPU가 빠르다”는 결론은 그다음에 나옵니다.
모델 라우팅의 비용 구조는 Muse Ember에서, 로컬 모델의 메모리 경계는 Nota AI의 1.58비트에서 이어서 볼 수 있습니다.